Table of Contents
รัน LLM 28.9M พารามิเตอร์บนไมโครอินพุตเตอร์ 8 ดอลลาร์: เทคนิค Per-Layer Embeddings ที่พลิกโฉม Edge AI
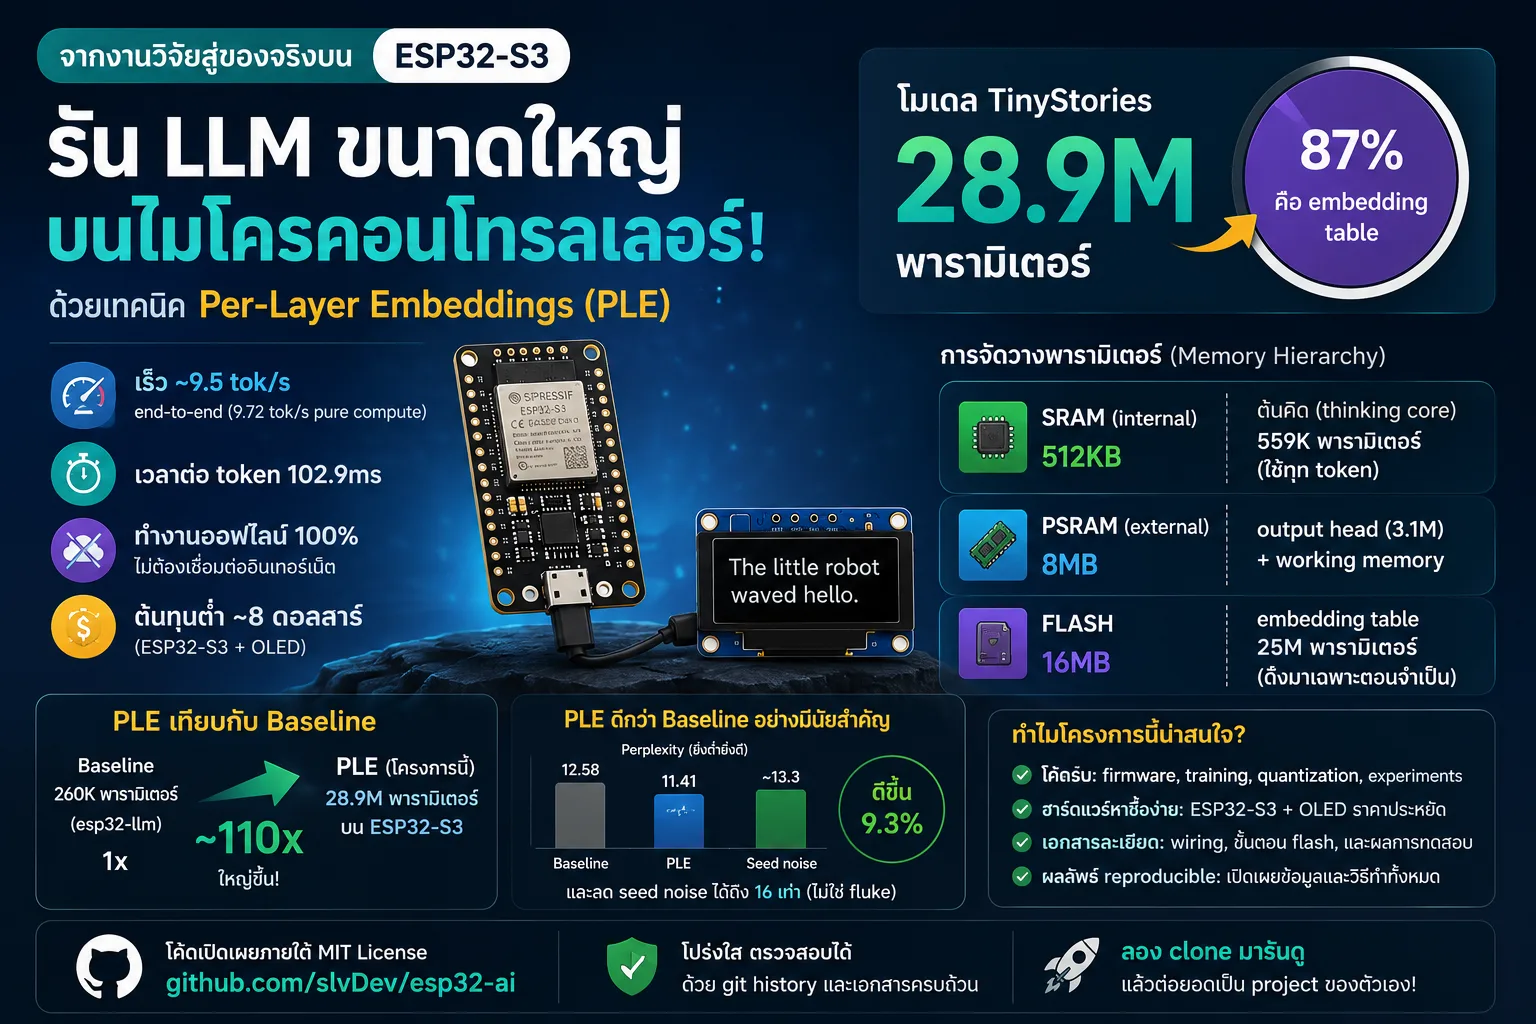
TL;DR — โครงการโอเพนซอร์สบน GitHub เพิ่งพิสูจน์ว่าคุณสามารถรัน language model ขนาด 28.9 ล้านพารามิเตอร์ บน ESP32-S3 ไมโครอินพุตเตอร์ที่ราคาเพียง 8 ดอลลาร์ ได้ที่ความเร็ว ~9.5 tokens/วินาที โดยไม่ส่งข้อมูลออกไปยังเซิร์ฟเวอร์เลย ความมหัศจรรย์อยู่ที่เทคนิค Per-Layer Embeddings (PLE) ที่ยืมมาจาก Google Gemma 3n/4 — เก็บพารามิเตอร์ส่วนใหญ่ไว้ใน flash memory และดึงมาใช้เฉพาะตอนจำเป็น ผลคือโมเดลใหญ่ขึ้น 110 เท่าจากสถิติเดิม บนชิปตัวเดียวกัน นี่คือก้าวสำคัญของ Edge AI ที่นักพัฒนาไทยควรจับตามอง
1. 🔬 ปัญหาเก่า: ทำไมรัน LLM บนไมโครอินพุตเตอร์ยากจัง?
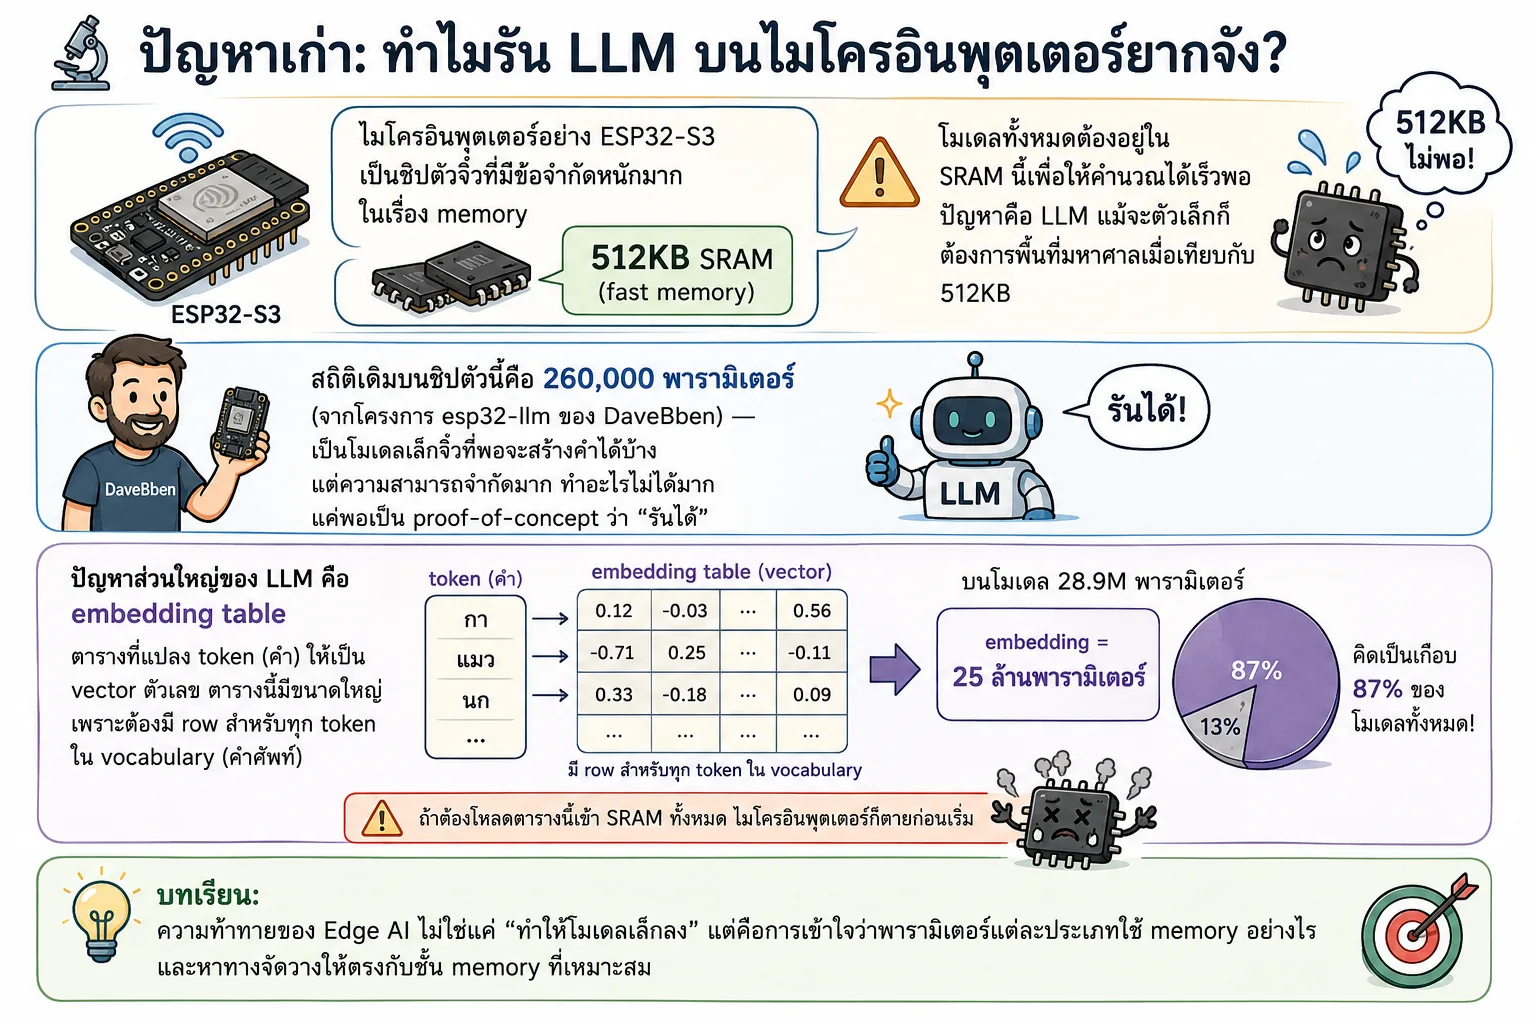
ไมโครอินพุตเตอร์อย่าง ESP32-S3 เป็นชิปตัวจิ๋วที่มีข้อจำกัดหนักมากในเรื่อง memory มันมี 512KB SRAM (fast memory) ซึ่งคือหัวใจสำคัญ — โมเดลทั้งหมดต้องอยู่ใน SRAM นี้เพื่อให้คำนวณได้เร็วพอ ปัญหาคือ LLM แม้จะตัวเล็กก็ต้องการพื้นที่มหาศาลเมื่อเทียบกับ 512KB
สถิติเดิมบนชิปตัวนี้คือ 260,000 พารามิเตอร์ (จากโครงการ esp32-llm ของ DaveBben) — เป็นโมเดลเล็กจิ๋วที่พอจะสร้างคำได้บ้าง แต่ความสามารถจำกัดมาก ทำอะไรไม่ได้มาก แค่พอเป็น proof-of-concept ว่า “รันได้”
ปัญหาส่วนใหญ่ของ LLM คือ embedding table — ตารางที่แปลง token (คำ) ให้เป็น vector ตัวเลข ตารางนี้มีขนาดใหญ่โตเพราะต้องมี row สำหรับทุก token ใน vocabulary (คำศัพท์) บนโมเดล 28.9M พารามิเตอร์ ส่วน embedding นี้คือ 25 ล้านพารามิเตอร์ — คิดเป็นเกือบ 87% ของโมเดลทั้งหมด! ถ้าต้องโหลดตารางนี้เข้า SRAM ทั้งหมด ไมโครอินพุตเตอร์ก็ตายก่อนเริ่ม
💡 บทเรียน: ความท้าทายของ Edge AI ไม่ใช่แค่ “ทำให้โมเดลเล็กลง” แต่คือการเข้าใจว่าพารามิเตอร์แต่ละประเภทใช้ memory อย่างไร และหาทางจัดวางให้ตรงกับชั้น memory ที่เหมาะสม
2. 🧠 ไอเดียหลัก: Per-Layer Embeddings คืออะไร?
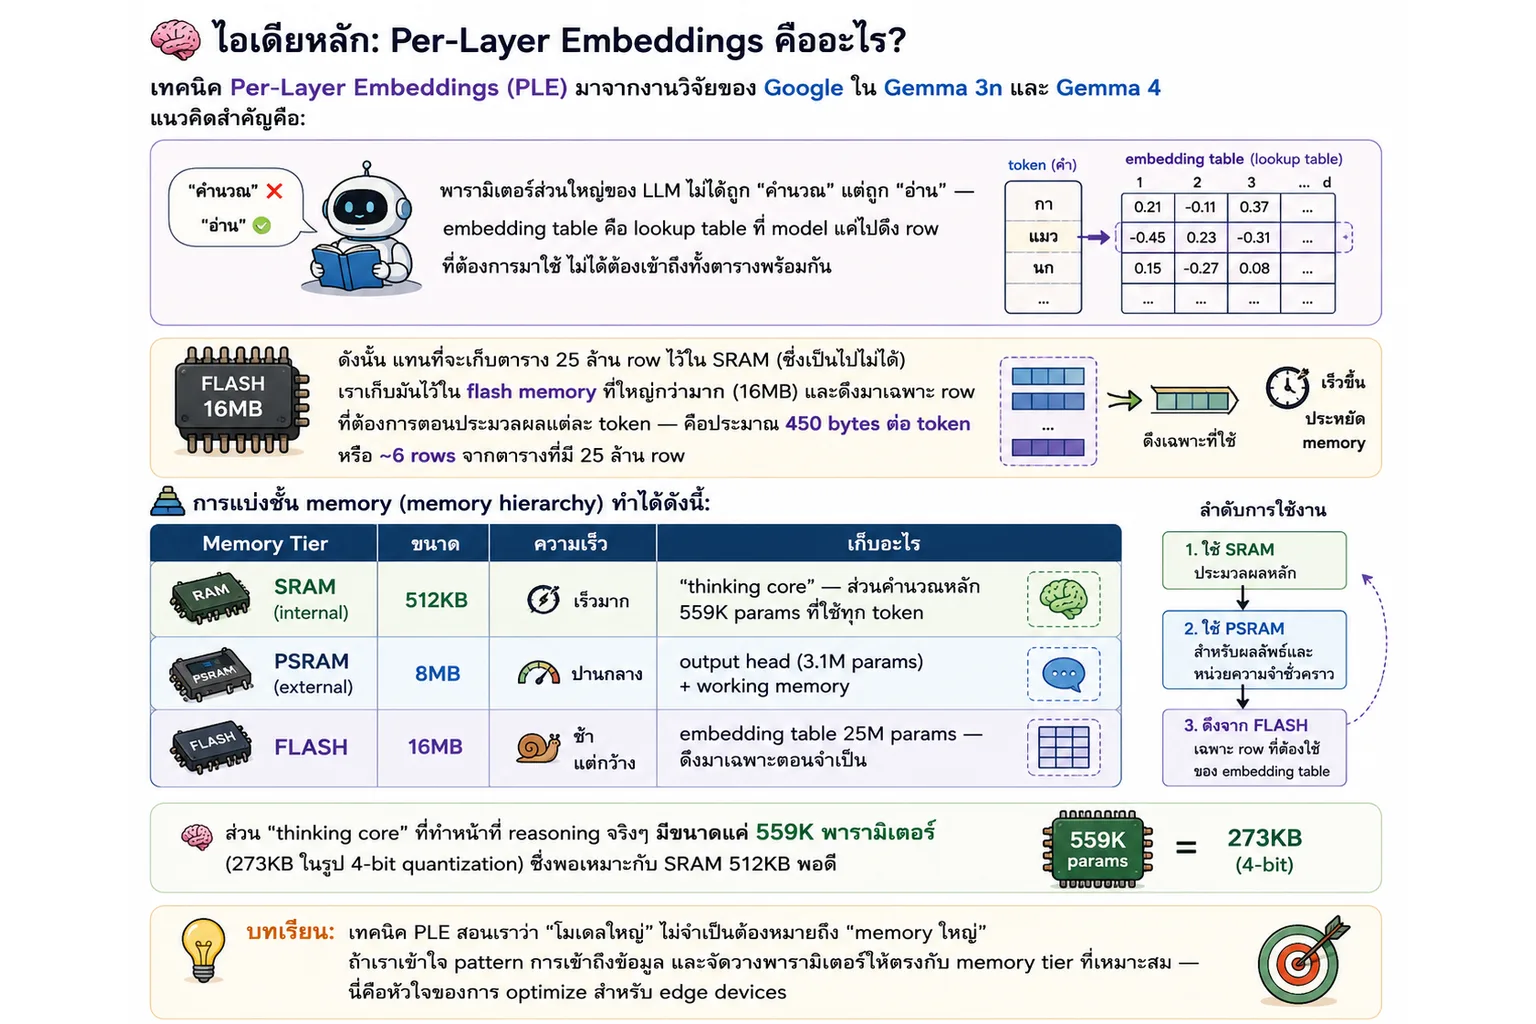
เทคนิค Per-Layer Embeddings (PLE) มาจากงานวิจัยของ Google ใน Gemma 3n และ Gemma 4 แนวคิดสำคัญคือ:
พารามิเตอร์ส่วนใหญ่ของ LLM ไม่ได้ถูก “คำนวณ” แต่ถูก “อ่าน” — embedding table คือ lookup table ที่ model แค่ไปดึง row ที่ต้องการมาใช้ ไม่ได้ต้องเข้าถึงทั้งตารางพร้อมกัน
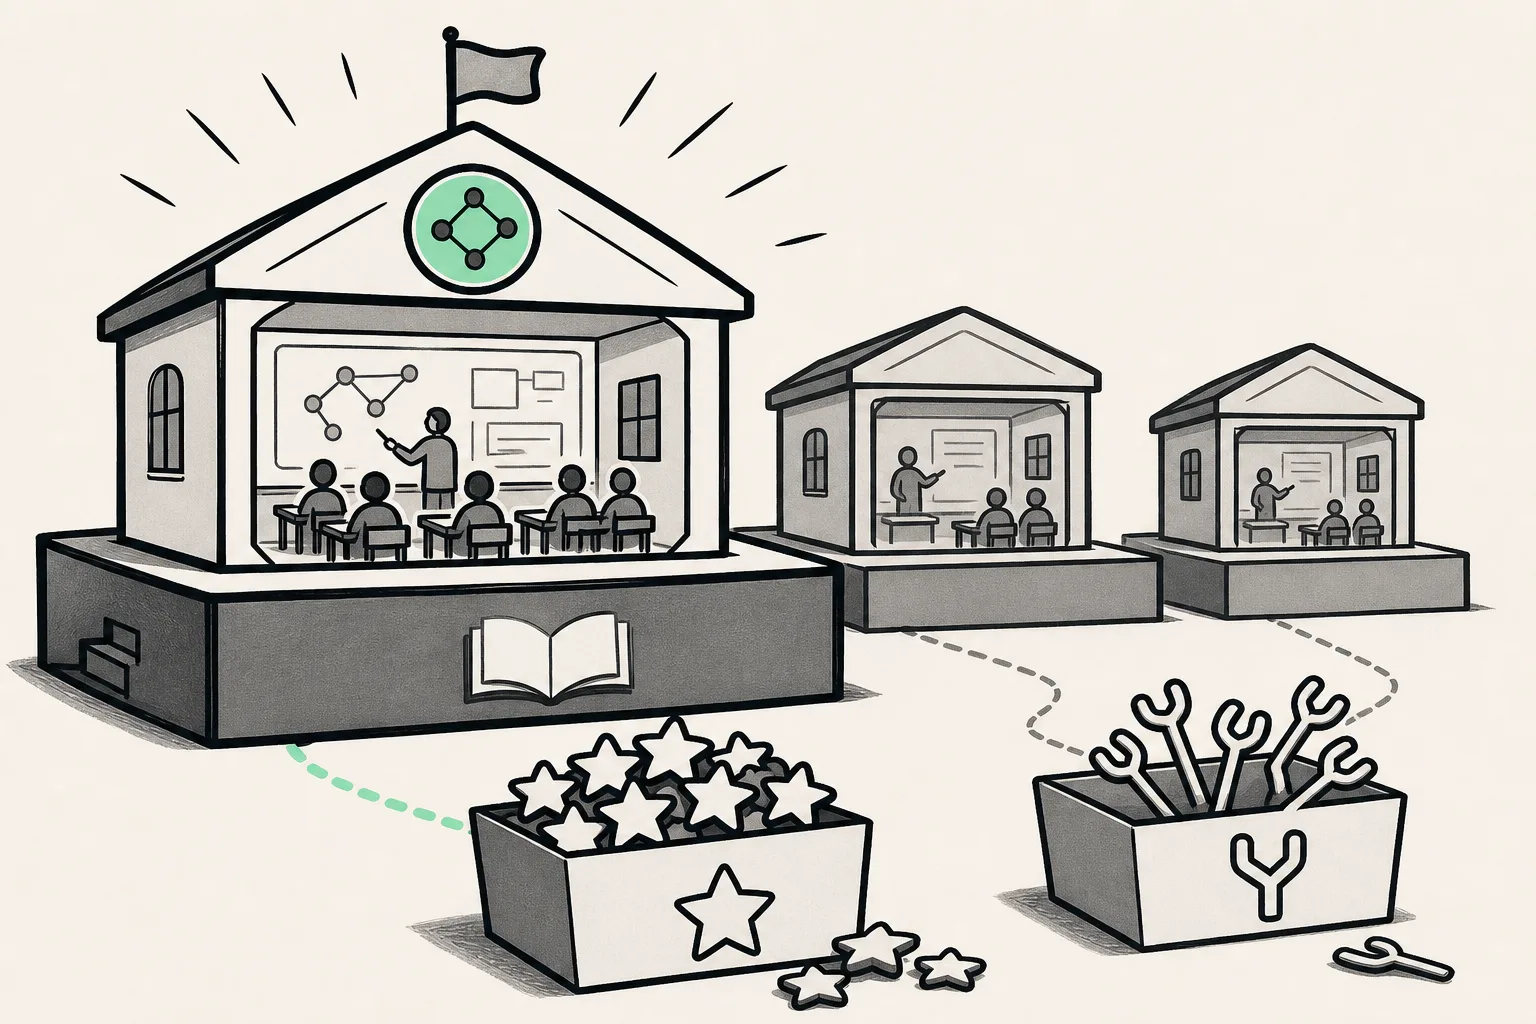
ดังนั้น แทนที่จะเก็บตาราง 25 ล้าน row ไว้ใน SRAM (ซึ่งเป็นไปไม่ได้) เราเก็บมันไว้ใน flash memory ที่ใหญ่กว่ามาก (16MB) และดึงมาเฉพาะ row ที่ต้องการตอนประมวลผลแต่ละ token — คือประมาณ 450 bytes ต่อ token หรือ ~6 rows จากตารางที่มี 25 ล้าน row
การแบ่งชั้น memory (memory hierarchy) ทำได้ดังนี้:
| Memory Tier | ขนาด | ความเร็ว | เก็บอะไร |
|---|---|---|---|
| SRAM (internal) | 512KB | เร็วมาก | “thinking core” — ส่วนคำนวณหลัก 559K params ที่ใช้ทุก token |
| PSRAM (external) | 8MB | ปานกลาง | output head (3.1M params) + working memory |
| FLASH | 16MB | ช้า แต่กว้าง | embedding table 25M params — ดึงมาเฉพาะตอนจำเป็น |
ส่วน “thinking core” ที่ทำหน้าที่ reasoning จริงๆ มีขนาดแค่ 559K พารามิเตอร์ (273KB ในรูป 4-bit quantization) ซึ่งพอเหมาะกับ SRAM 512KB พอดี
💡 บทเรียน: เทคนิค PLE สอนเราว่า “โมเดลใหญ่” ไม่จำเป็นต้องหมายถึง “memory ใหญ่” ถ้าเราเข้าใจ pattern การเข้าถึงข้อมูล และจัดวางพารามิเตอร์ให้ตรงกับ memory tier ที่เหมาะสม — นี่คือหัวใจของการ optimize สำหรับ edge devices
3. 📊 ผลลัพธ์จริง: ตัวเลขที่น่าประหลาดใจ
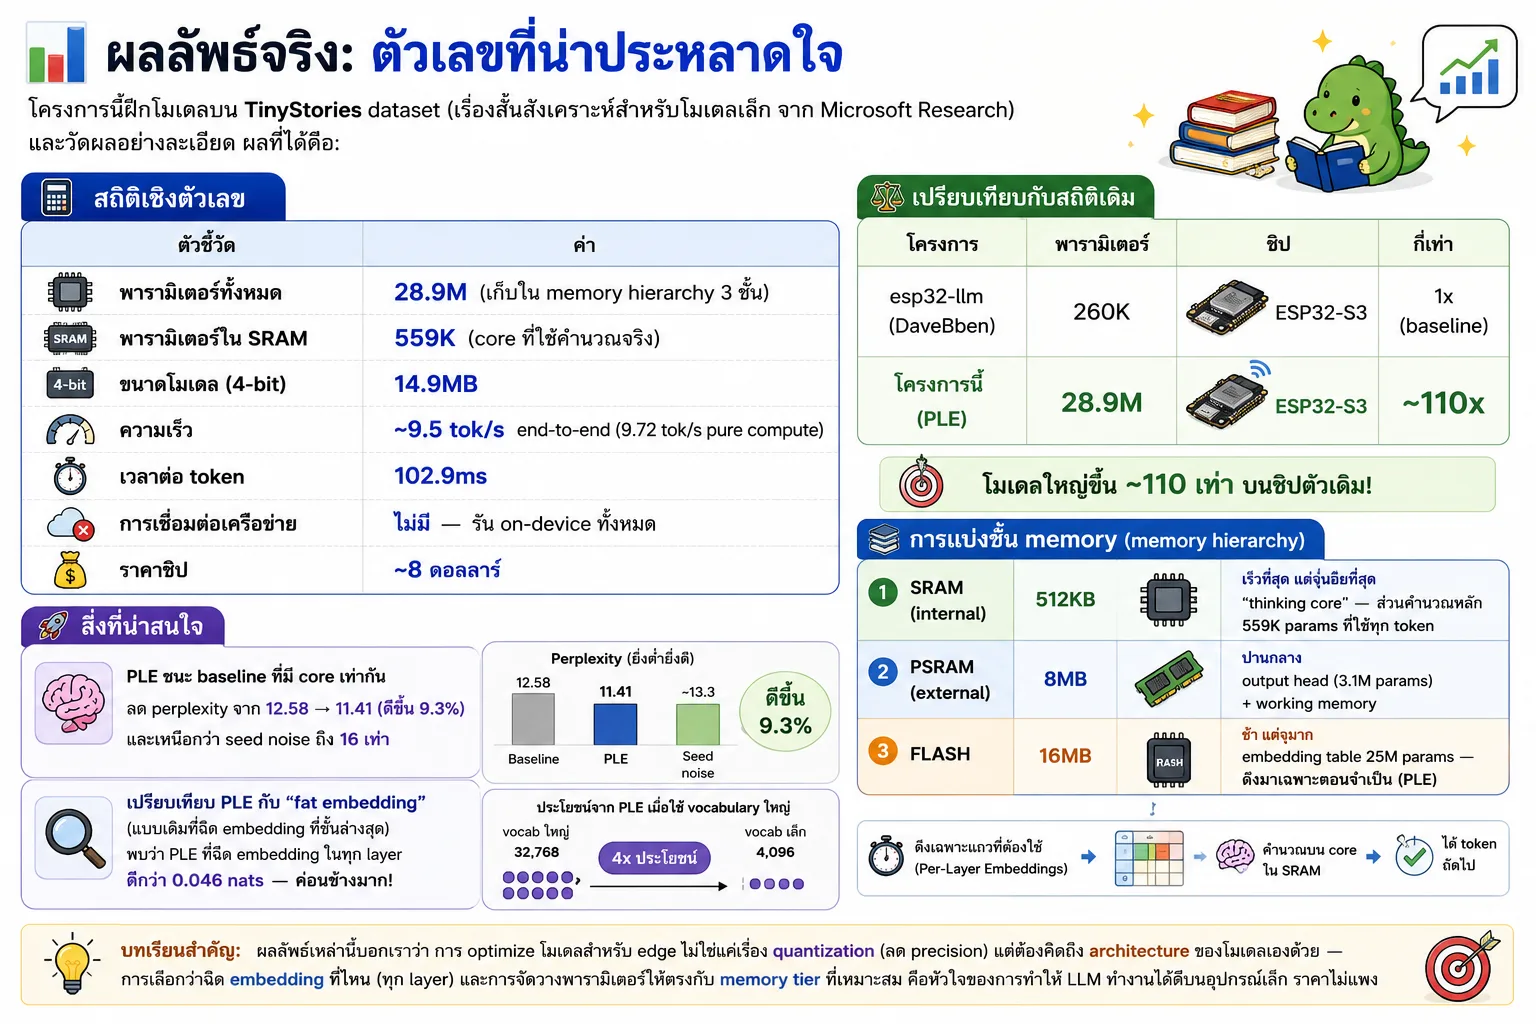
โครงการนี้ฝึกโมเดลบน TinyStories dataset (เรื่องสั้นสังเคราะห์สำหรับโมเดลเล็ก จาก Microsoft Research) และวัดผลอย่างละเอียด ผลที่ได้คือ:
สถิติเชิงตัวเลข
| ตัวชี้วัด | ค่า |
|---|---|
| พารามิเตอร์ทั้งหมด | 28.9M (เก็บใน memory hierarchy 3 ชั้น) |
| พารามิเตอร์ใน SRAM | 559K (core ที่ใช้คำนวณจริง) |
| ขนาดโมเดล (4-bit) | 14.9MB |
| ความเร็ว | ~9.5 tok/s end-to-end (9.72 tok/s pure compute) |
| เวลาต่อ token | 102.9ms |
| การเชื่อมต่อเครือข่าย | ไม่มี — รัน on-device ทั้งหมด |
| ราคาชิป | ~8 ดอลลาร์ |
เปรียบเทียบกับสถิติเดิม
| โครงการ | พารามิเตอร์ | ชิป | กี่เท่า |
|---|---|---|---|
| esp32-llm (DaveBben) | 260K | ESP32-S3 | 1x (baseline) |
| โครงการนี้ (PLE) | 28.9M | ESP32-S3 | ~110x |
การที่ PLE ชนะ baseline ที่มี core เท่ากัน โดยลด perplexity จาก 12.58 → 11.41 (ดีขึ้น 9.3%) และเหนือกว่า seed noise ถึง 16 เท่า แสดงว่าไม่ใช่ fluke — เทคนิคนี้ทำงานได้จริง
นอกจากนี้ การเปรียบเทียบ PLE กับ “fat embedding” (แบบเดิมที่ฉีด embedding ที่ชั้นล่างสุด) พบว่า PLE ที่ฉีด embedding ในทุก layer ดีกว่า 0.046 nats — ยิ่ง vocabulary ใหญ่ ยิ่งได้ประโยชน์มาก (ที่ vocab 32768 ได้ประโยชน์ 4x เทียบกับ vocab 4096)
💡 บทเรียน: ผลลัพธ์เหล่านี้บอกเราว่าการ optimize โมเดลสำหรับ edge ไม่ใช่แค่เรื่อง quantization (ลด precision) แต่ต้องคิดถึง architecture ของโมเดลเองด้วย — การเลือกว่าฉีด embedding ที่ไหน มีผลต่อประสิทธิภาพไม่น้อยกว่าการลดขนาดเลย
4. 🔧 เปิดดูส่วนประกอบ: โค้ดและวิธีรันเอง
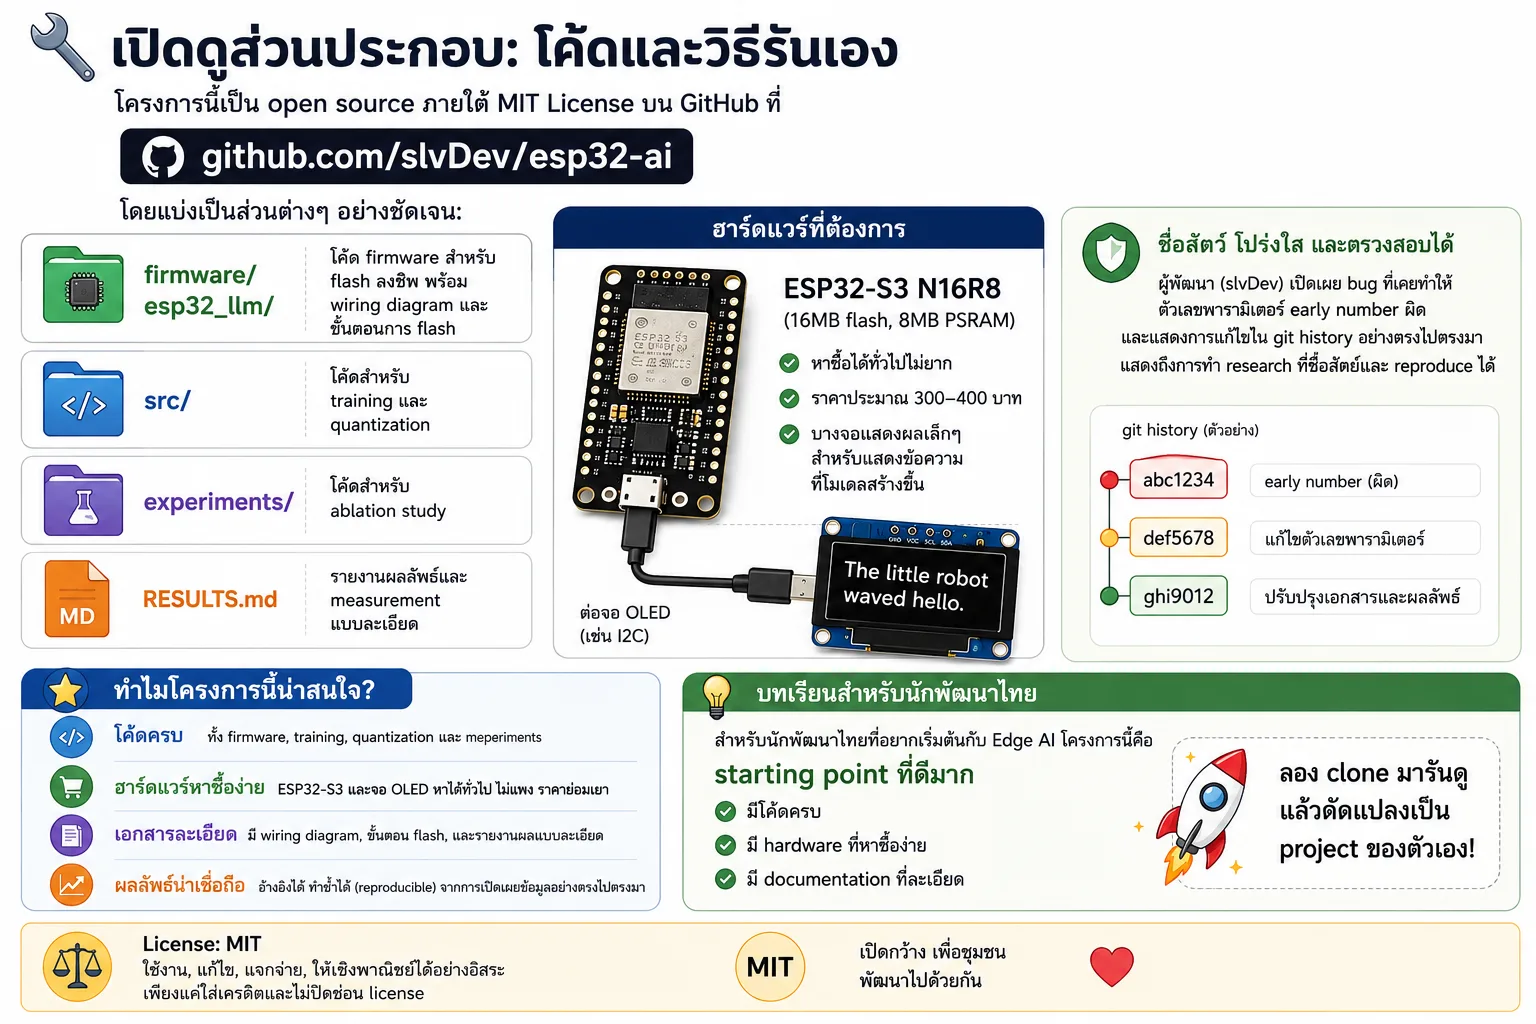
โครงการนี้เป็น open source ภายใต้ MIT License บน GitHub ที่ github.com/slvDev/esp32-ai โดยแบ่งเป็นส่วนต่างๆ อย่างชัดเจน:
- firmware/esp32_llm/ — โค้ด firmware สำหรับ flash ลงชิพ พร้อม wiring diagram และขั้นตอนการ flash
- src/ — โค้ดสำหรับ training และ quantization
- experiments/ — โค้ดสำหรับ ablation study
- RESULTS.md — รายงานผลลัพธ์และ measurement แบบละเอียด
อุปกรณ์ที่ต้องการคือ ESP32-S3 N16R8 (16MB flash, 8MB PSRAM) ที่หาซื้อได้ทั่วไปในไทย ราคาประมาณ 300-400 บาท บวกจอแสดงผลเล็กๆ สำหรับแสดงข้อความที่โมเดลสร้างขึ้น
ที่น่าชื่นชมคือผู้พัฒนา (slvDev) เปิดเผย bug ที่เคยทำให้ตัวเลขพารามิเตอร์ early number ผิด และแสดงการแก้ไขใน git history อย่างตรงไปตรงมา — แสดงถึงการทำ research ที่ซื่อสัตย์และ reproduce ได้
💡 บทเรียน: สำหรับนักพัฒนาไทยที่อยากเริ่มต้นกับ Edge AI โครงการนี้คือ starting point ที่ดีมาก — มีโค้ดครบ มี hardware ที่หาซื้อง่าย และมี documentation ที่ละเอียด ลอง clone มารันดู แล้วดัดแปลงเป็น project ของตัวเอง
5. 🌏 สำคัญอย่างไรสำหรับวงการ AI ไทย?
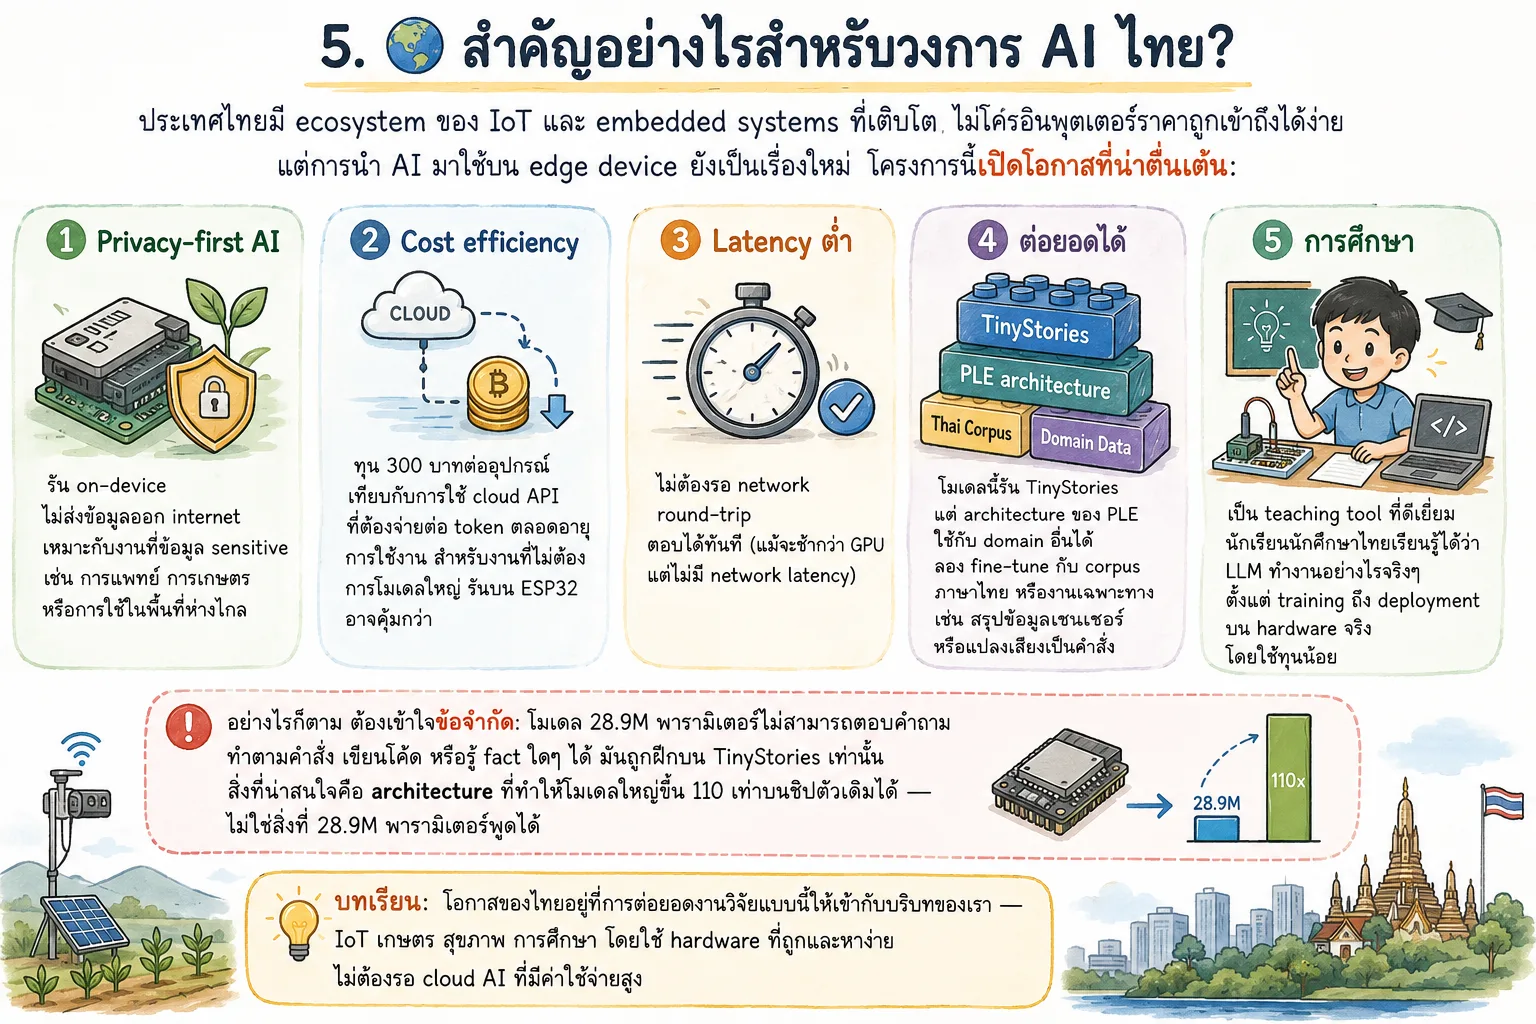
ประเทศไทยมี ecosystem ของ IoT และ embedded systems ที่เติบโต ไมโครอินพุตเตอร์ราคาถูกเข้าถึงได้ง่าย แต่การนำ AI มาใช้บน edge device ยังเป็นเรื่องใหม่ โครงการนี้เปิดโอกาสที่น่าตื่นเต้น:
-
Privacy-first AI — รัน on-device ไม่ส่งข้อมูลออก internet เหมาะกับงานที่ข้อมูล sensitive เช่น การแพทย์ การเกษตร หรือการใช้ในพื้นที่ห่างไกล
-
Cost efficiency — ทุน 300 บาทต่ออุปกรณ์ เทียบกับการใช้ cloud API ที่ต้องจ่ายต่อ token ตลอดอายุการใช้งาน สำหรับงานที่ไม่ต้องการโมเดลใหญ่ รันบน ESP32 อาจคุ้มกว่า
-
Latency ต่ำ — ไม่ต้องรอ network round-trip ตอบได้ทันที (แม้จะช้ากว่า GPU แต่ไม่มี network latency)
-
ต่อยอดได้ — โมเดลนี้รัน TinyStories แต่ architecture ของ PLE ใช้กับ domain อื่นได้ ลอง fine-tune กับ corpus ภาษาไทย หรืองานเฉพาะทาง เช่น สรุปข้อมูลเซนเซอร์ หรือแปลงเสียงเป็นคำสั่ง
-
การศึกษา — เป็น teaching tool ที่ดีเยี่ยม นักเรียนนักศึกษาไทยเรียนรู้ได้ว่า LLM ทำงานอย่างไรจริงๆ ตั้งแต่ training ถึง deployment บน hardware จริง โดยใช้ทุนน้อย
อย่างไรก็ตาม ต้องเข้าใจข้อจำกัด: โมเดล 28.9M พารามิเตอร์ไม่สามารถตอบคำถาม ทำตามคำสั่ง เขียนโค้ด หรือรู้ fact ใดๆ ได้ มันถูกฝึกบน TinyStories เท่านั้น สิ่งที่น่าสนใจคือ architecture ที่ทำให้โมเดลใหญ่ขึ้น 110 เท่าบนชิปตัวเดิมได้ — ไม่ใช่สิ่งที่ 28.9M พารามิเตอร์พูดได้
💡 บทเรียน: โอกาสของไทยอยู่ที่การต่อยอดงานวิจัยแบบนี้ให้เข้ากับบริบทของเรา — IoT เกษตร สุขภาพ การศึกษา โดยใช้ hardware ที่ถูกและหาง่าย ไม่ต้องรอ cloud AI ที่มีค่าใช้จ่ายสูง
6. 🔮 อนาคตของ Edge LLM: มากกว่าแค่ไมโครอินพุตเตอร์
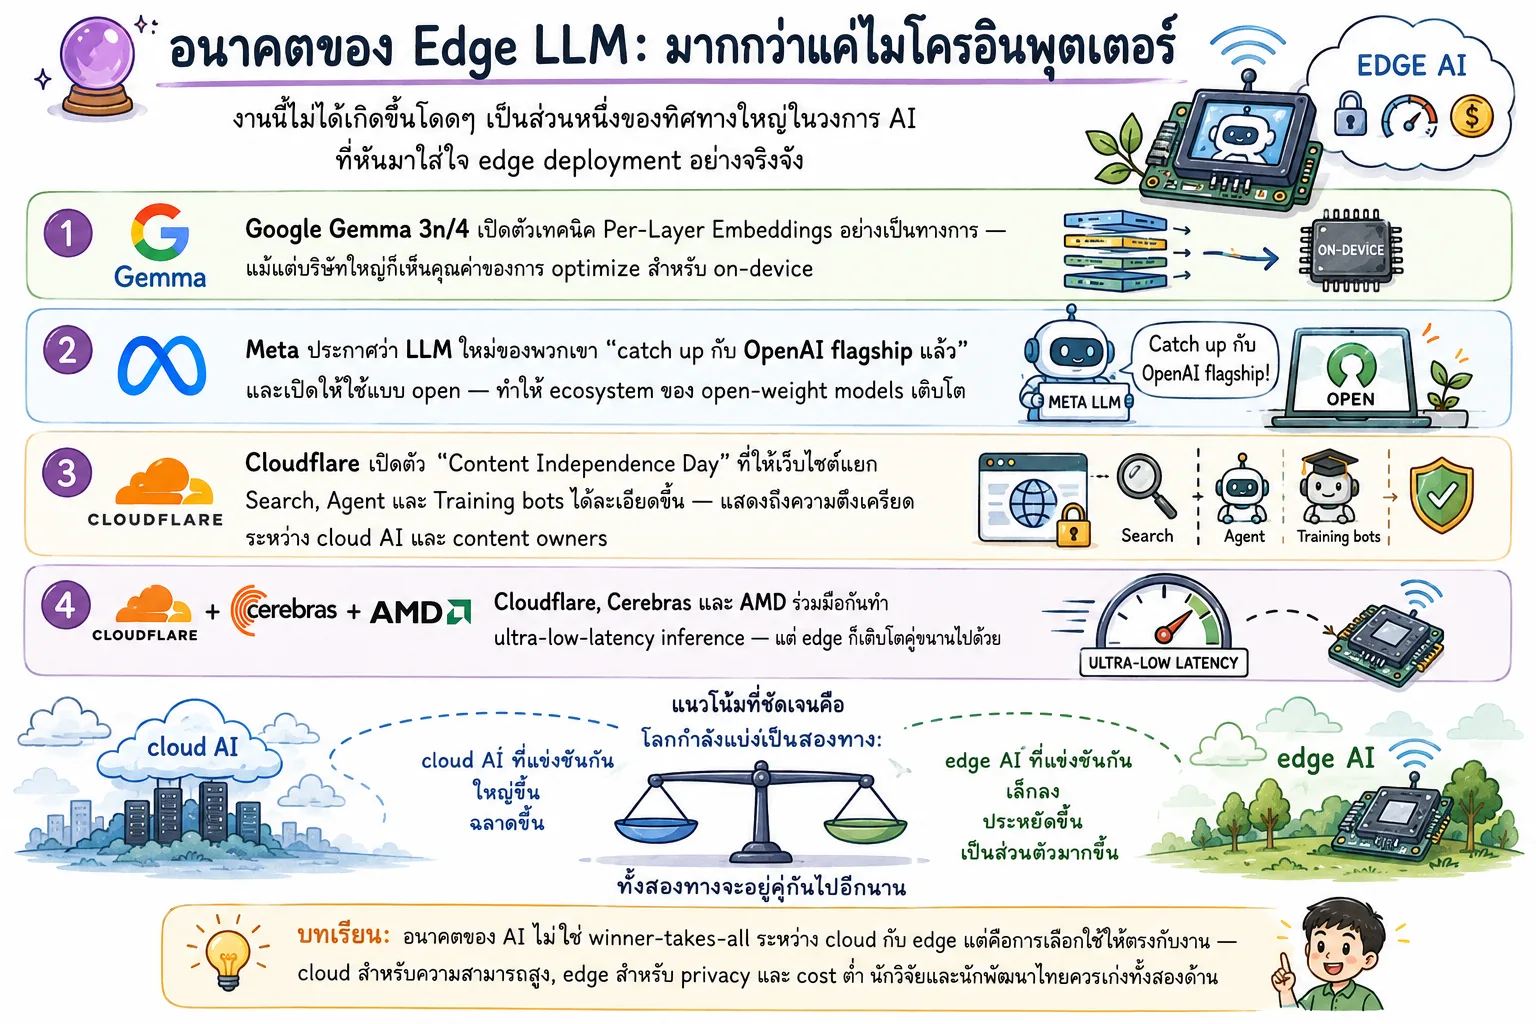
งานนี้ไม่ได้เกิดขึ้นโดดๆ เป็นส่วนหนึ่งของทิศทางใหญ่ในวงการ AI ที่หันมาใส่ใจ edge deployment อย่างจริงจัง:
- Google Gemma 3n/4 เปิดตัวเทคนิค Per-Layer Embeddings อย่างเป็นทางการ — แม้แต่บริษัทใหญ่ก็เห็นคุณค่าของการ optimize สำหรับ on-device
- Meta ประกาศว่า LLM ใหม่ของพวกเขา “catch up กับ OpenAI flagship แล้ว” และเปิดให้ใช้แบบ open — ทำให้ ecosystem ของ open-weight models เติบโต
- Cloudflare เปิดตัว “Content Independence Day” ที่ให้เว็บไซต์แยก Search, Agent และ Training bots ได้ละเอียดขึ้น — แสดงถึงความตึงเครียดระหว่าง cloud AI และ content owners
- Cloudflare, Cerebras และ AMD ร่วมมือกันทำ ultra-low-latency inference — แต่ edge ก็เติบโตคู่ขนานไปด้วย
แนวโน้มที่ชัดเจนคือ โลกกำลังแบ่งเป็นสองทาง: cloud AI ที่แข่งกันใหญ่ขึ้น ฉลาดขึ้น และ edge AI ที่แข่งกันเล็กลง ประหยัดขึ้น และเป็นส่วนตัวมากขึ้น — ทั้งสองทางจะอยู่คู่กันไปอีกนาน
💡 บทเรียน: อนาคตของ AI ไม่ใช่ winner-takes-all ระหว่าง cloud กับ edge แต่คือการเลือกใช้ให้ตรงกับงาน — cloud สำหรับความสามารถสูง, edge สำหรับ privacy และ cost ต่ำ นักวิจัยและนักพัฒนาไทยควรเก่งทั้งสองด้าน
FAQ — คำถามที่พบบ่อย
Q1: โมเดลนี้ทำอะไรได้บ้าง? A: ตอนนี้ฝึกบน TinyStories เท่านั้น — สร้างเรื่องสั้นง่ายๆ ได้ แต่ไม่ตอบคำถาม ไม่ทำตามคำสั่ง ไม่รู้ fact สิ่งที่น่าสนใจคือ architecture ที่ทำให้ใส่พารามิเตอร์ได้มากขึ้น 110 เท่า บนชิปตัวเดิม ไม่ใช่สิ่งที่โมเดลพูดได้
Q2: ซื้อ ESP32-S3 ในไทยได้ที่ไหน? A: หาซื้อได้ทั่วไปทางออนไลน์ ร้านอุปกรณ์อิเล็กทรอนิกส์ ราคาประมาณ 300-400 บาท รุ่นที่ต้องการคือ N16R8 (16MB flash, 8MB PSRAM) ตรงตามสเปคใน README
Q3: ทำไมต้องเก็บ embedding ใน flash ไม่ใช่ RAM? A: เพราะ embedding table มี 25 ล้าน row แต่แต่ละ token ใช้แค่ ~6 row (~450 bytes) เก็บใน flash ที่ใหญ่กว่าและดึงมาเฉพาะตอนจำเป็น ประหยัด SRAM ได้มหาศาล — นี่คือหัวใจของ PLE
Q4: 9.5 tok/s นี่เร็วพอไหม? A: พอใช้สำหรับงานที่ไม่เร่งด่วน — ประมาณคนอ่านหนังสือเร็วปานกลาง สำหรับ interactive chat ยังช้าไป แต่สำหรับงาน background หรือการแสดงผลบนจอเล็กๆ ถือว่าใช้ได้
Q5: ใช้เทคนิคนี้กับโมเดลใหญ่กว่านี้ได้ไหม? A: ได้ในทางทฤษฎี แต่ต้องแลกกับเวลา training และขนาด flash ที่ใหญ่ขึ้น ประเด็นสำคัญคือโมเดลยังจำกัดอยู่ที่ขนาดของ “thinking core” ที่ต้องอยู่ใน SRAM ทำให้ไม่สามารถเพิ่มความสามารถได้มากนัก — PLE ช่วยให้ใส่พารามิเตอร์ได้มากขึ้น แต่ไม่ได้เพิ่มความสามารถของ core โดยตรง
English Summary
An open-source project on GitHub (slvDev/esp32-ai) demonstrates running a 28.9 million parameter language model on an ESP32-S3 microcontroller that costs approximately $8. The key innovation is the use of Per-Layer Embeddings (PLE), a technique from Google’s Gemma 3n/4 models, which stores the 25 million parameter embedding table in flash memory and retrieves only the ~6 rows needed per token (~450 bytes), keeping only the 559K parameter “thinking core” in the 512KB SRAM. This achieves ~9.5 tokens/second end-to-end on-device, with no network connection — a 110x improvement in parameter count over the previous record on the same chip. The model is trained on TinyStories and produces coherent short stories but cannot answer questions or follow instructions. The architecture insight — that most LLM parameters are “read” rather than “computed,” enabling a memory hierarchy split — is the real contribution, with broad implications for privacy-first, low-cost Edge AI applications. The project is MIT-licensed with full training code, firmware, and detailed ablation results available on GitHub, making it an excellent starting point for developers and educators exploring on-device AI.
Sources:
- GitHub Repository: https://github.com/slvDev/esp32-ai (1300+ stars, MIT License)
- Hacker News Discussion: https://news.ycombinator.com/item?id=49050512 (269 points)
- RESULTS.md (detailed ablation): https://github.com/slvDev/esp32-ai/blob/main/RESULTS.md
- Per-Layer Embeddings (Google Gemma 3n/4): https://blog.google/technology/developers/gemma-3n/
- TinyStories dataset (Microsoft Research): https://arxiv.org/abs/2305.07759