Table of Contents
- TL;DR
- 1. Claude Opus 5 คืออะไร? ทำไมพูดถึงกันทั้งวงการ?
- 2. Benchmark ที่อยู่ในความสนใจ: Opus 5 เทียบกับรุ่นก่อนและคู่แข่ง
- 3. Pricing and Cost-Effectiveness: คุ้มจริงไหม?
- 4. Agentic Coding และความสม่ำเสมอ: เกมเปลี่ยนจริงหรือ?
- 5. Safety and Alignment: โมเดลที่ aligned ที่สุดเท่าที่เคยมีมา
- 6. สิ่งที่นักพัฒนาและธุรกิจไทยควรทำต่อจากนี้
- FAQ
- English Summary
- Sources
- AI Pricing Guru - Opus 5 Pricing Analysis - Cost-per-task analysis
- 7. วิเคราะห์เชิงลึก: Opus 5 ในบริบทการแข่งขัน LLM ระดับโลก
- 8. เปรียบเทียบ Opus 5 กับโมเดลอื่นๆ ในตลาด
- 9. ผลกระทบต่อ Vibe Coding และ AI-Assisted Development
- 10. สรุปและข้อแนะนำสำหรับผู้อ่าน thanawat.ai
Claude Opus 5: โมเดล AI อันดับ 1 ของโลกที่เพิ่งเปิดตัว - ทำไมนักพัฒนาไทยควรสนใจ?
TL;DR
Anthropic เปิดตัว Claude Opus 5 เมื่อวันที่ 24 กรกฎาคม 2026 โมเดลใหม่ล่าสุดที่คว้าอันดับ 1 บน Artificial Analysis Intelligence Index (คะแนน 61 จากค่าเฉลี่ย 32) ทำลายสถิติทั้งด้าน coding, agentic tasks และ computer use ขณะที่ราคาถูกกว่า Fable 5 ถึงครึ่งหนึ่ง ด้วย context window 1M tokens, adaptive reasoning และความสม่ำเสมอที่ดีขึ้นอย่างมาก Opus 5 กำลังเปลี่ยนเกมการพัฒนา AI ไปตลอด
1. Claude Opus 5 คืออะไร? ทำไมพูดถึงกันทั้งวงการ?
วันที่ 24 กรกฎาคม 2026 Anthropic ประกาศเปิดตัว Claude Opus 5 อย่างเป็นทางการ และภายในไม่กี่ชั่วโมงก็กลายเป็นกระทู้อันดับ 1 บน Hacker News ด้วยคะแนน 1,089 และความคิดเห็นกว่า 581 ข้อความ นี่ไม่ใช่การอัปเดตเล็กๆ - แต่เป็น step change ตามคำกล่าวของ Anthropic เอง
จุดที่น่าสนใจที่สุดคือ Opus 5 สามารถเทียบเคียง intelligence ของ Claude Fable 5 (โมเดล flagship ระดับสูงสุด) ได้ที่ราคาถูกกว่าครึ่งหนึ่ง พูดง่ายๆ คือคุณได้ประสิทธิภาพระดับ top-tier ในราคาที่เข้าถึงได้มากขึ้น
บน Artificial Analysis ซึ่งเป็น platform จัดอันดับ AI models อิสระ Claude Opus 5 ขึ้นแท่นเป็นอันดับ 1 จาก 191 โมเดลทั่วโลก ด้วยคะแนน Intelligence Index ที่ 61 ซึ่งสูงกว่าค่าเฉลี่ย (32) เกือบสองเท่า นี่คือการยืนยันจากภายนอกว่า Opus 5 ไม่ใช่แค่การโฆษณาแต่เป็นผลลัพธ์จริง
บทเรียน: เมื่อเลือกใช้ LLM อย่าดูแค่ข้อมูลจากผู้ผลิต ให้เช็คกับ benchmark อิสระอย่าง Artificial Analysis เสมอ เพราะคะแนนจาก third-party มีความน่าเชื่อถือสูงกว่าและเปรียบเทียบได้ข้ามโมเดล
2. Benchmark ที่อยู่ในความสนใจ: Opus 5 เทียบกับรุ่นก่อนและคู่แข่ง
Anthropic อ้างว่า Opus 5 เป็น state-of-the-art บนหลาย benchmark สำคัญ มาดูตัวเลขกัน:
| Benchmark | ผลลัพธ์ Claude Opus 5 | เทียบกับ |
|---|---|---|
| Artificial Analysis Intelligence Index | อันดับ 1/191 (คะแนน 61) | ค่าเฉลี่ย 32 |
| Frontier-Bench v0.1 (coding) | State-of-the-art | ดีกว่า Opus 4.8 กว่า 2 เท่า ที่ cost/task ต่ำกว่า |
| OSWorld 2.0 (computer use) | ดีที่สุดในทุกระดับราคา | ดีกว่า Fable 5 ที่ 1/3 ของราคา |
| Agentic coding tasks (internal) | ดีขึ้น 22% | เทียบกับ Opus 4.7 |
| Zapier AutomationBench | pass rate 1.5x ของรองชนะเลิศ | ที่ cost/task เดียวกัน |
| Novel problem-solving | คะแนน 3x ของโมเดลอันดับ 2 | - |
| Cybersecurity tasks | ยังตาม Mythos 5 อยู่ | จุดอ่อนที่ต้องระวัง |
ข้อมูลจาก Artificial Analysis ยังเผยว่า Opus 5 มี context window 1M tokens รองรับทั้ง text และ image input และใช้ระบบ adaptive reasoning ที่ให้ผู้ใช้เลือกระดับ effort ได้ - ปรับสูงเพื่อ intelligence สูงสุด หรือลดลงเพื่อประหยัด tokens
บทเรียน: อย่าดูแค่คะแนนรวม ให้ดูว่าโมเดลเด่นที่ task อะไร Opus 5 แข็งแกร่งมากใน coding และ agentic tasks แต่อาจไม่ใช่ตัวเลือกที่ดีที่สุดสำหรับ cybersecurity การเลือกโมเดลให้ตรงกับ use case สำคัญกว่าการไล่ตามคะแนนรวม
3. Pricing and Cost-Effectiveness: คุ้มจริงไหม?
นี่คือส่วนที่นักพัฒนาไทยสนใจมากที่สุด ราคา API ของ Claude Opus 5 อยู่ที่:
- Input: $5.00 per 1M tokens
- Output: $25.00 per 1M tokens
- Cache Write: $6.25 per 1M tokens
- Cache Hit: $0.50 per 1M tokens (ลด 90%)
- Speed: 56.3 tokens/sec (ช้ากว่าค่าเฉลี่ย 74 tokens/sec)
เมื่อเทียบกับ Fable 5 ซึ่งเป็นโมเดลระดับเดียวกันในแง่ intelligence Opus 5 ถูกกว่าประมาณ 50% แต่มีข้อแลกเปลี่ยนคือ speed ที่ช้ากว่าค่าเฉลี่ย อย่างไรก็ตาม Anthropic เน้นว่า cost per task สำคัญกว่า cost per token เพราะถ้าโมเดลทำงานเสร็จในครั้งเดียวโดยไม่ต้อง retry ก็ถูกกว่าในระยะยาว
การที่มี adaptive reasoning effort settings ช่วยให้นักพัฒนาสามารถปรับระดับได้ ใช้ high effort สำหรับงานยาก และ low effort สำหรับงานง่ายเพื่อประหยัด tokens และเพิ่มความเร็ว
บทเรียน: สำหรับทีมไทยที่ใช้ API ใน production ให้คำนวณ cost per completed task แทน cost per token โมเดลที่ถูกกว่าแต่ต้อง retry บ่อยอาจแพงกว่าในระยะยาว การใช้ prompt caching ช่วยลดค่าใช้จ่ายได้มากถึง 90%
4. Agentic Coding และความสม่ำเสมอ: เกมเปลี่ยนจริงหรือ?
นี่คือจุดที่ Opus 5 โดดเด่นที่สุด Anthropic รายงานว่าบน agentic coding tasks ที่ยากที่สุด Opus 5 ดีขึ้น 22% เทียบกับ Opus 4.7 แต่ที่สำคัญกว่าคือ far less variance run to run
Fabian Hedin จาก Lovable (platform สร้างแอปด้วย AI ที่มีผู้ใช้หลายล้านคน) กล่าวว่า consistency is the whole game - ผลลัพธ์ที่สม่ำเสมอ build after build สำคัญกว่าคะแนนสูงๆ ครั้งเดียว
สำหรับนักพัฒนาที่ใช้ AI ใน vibe coding หรือ AI-assisted development ความสม่ำเสมอนี้หมายความว่า:
- ลดความเสี่ยงในการได้ผลลัพธ์ที่ไม่ดีจากการสุ่ม
- ลดเวลาในการ debug และ retry
- ทำให้การใช้ AI ใน production pipeline น่าเชื่อถือมากขึ้น
- ลดต้นทุนรวมเพราะไม่ต้องรันซ้ำ
นอกจากนี้ Opus 5 ยังเป็น default model บน Claude Max และเป็นโมเดลที่แข็งแกร่งที่สุดบน Claude Pro ที่หมายความว่าผู้ใช้ทั่วไปก็เข้าถึงได้โดยไม่ต้องจ่ายระดับ enterprise
บทเรียน: สำหรับการนำ AI ไปใช้ใน production ความสม่ำเสมอ (consistency) สำคัญกว่า peak performance โมเดลที่ให้ผลลัพธ์ 80/100 ทุกครั้ง ดีกว่าโมเดลที่ให้ 100/100 บางครั้งและ 50/100 บางครั้ง เพราะความคาดเดไม่ได้ทำลาย pipeline และความเชื่อมั่นของทีม
5. Safety and Alignment: โมเดลที่ aligned ที่สุดเท่าที่เคยมีมา
Anthropic รายงานว่าจากการทดสอบ pre-deployment ระบบ automated behavioral audit พบว่า Opus 5 เป็นโมเดลที่ most aligned model to date - ยึดติดกับ Claude Constitution ได้ดีกว่า Opus 4.8, Sonnet 5 หรือแม้แต่ Fable 5
อย่างไรก็ตาม Anthropic ยอมรับว่าโมเดลยังมี limitations บน long-running autonomous research tasks ซึ่งเป็นจุดที่พวกเขาคาดว่า AI จะมีความเสี่ยงด้าน biology-related มากที่สุด และ Mythos 5 ยังเป็นโมเดลที่แข็งแกร่งกว่าสำหรับงานประเภทนี้
เพื่อความปลอดภัย Anthropic ได้เพิ่มการจำกัด biology-related requests บน Opus 5 ด้วย ซึ่งเป็นสัญญาณว่าพวกเขากำลังจริงจังกับ AI safety แม้จะเร่งพัฒนา performance ก็ตาม
บทเรียน: การที่โมเดลแข็งแกร่งขึ้นไม่ได้แปลว่าปลอดภัยน้อยลง - แต่ตรงกันข้าม การลงทุนใน alignment และ safety ไปพร้อมกับ performance เป็นสิ่งที่องค์กรควรทำ สำหรับทีมไทยที่นำ AI ไปใช้ในธุรกิจ ควรมี guardrails และ monitoring เป็นของตัวเอง ไม่ใช่พึ่งพา safety ของผู้ผลิตโมเดลอย่างเดียว
6. สิ่งที่นักพัฒนาและธุรกิจไทยควรทำต่อจากนี้
Claude Opus 5 เปิดโอกาสใหม่ๆ สำหรับทีมไทยหลายระดับ:
สำหรับนักพัฒนาอิสระและ startup:
- ลองใช้ผ่าน Claude Pro ($20/เดือน) เพื่อทดสอบกับงานจริง
- ใช้ adaptive reasoning effort ในการ optimize cost
- ทดสอบความสม่ำเสมอบน coding tasks ที่คุณทำบ่อยๆ
สำหรับทีมที่ใช้ API ใน production:
- คำนวณ cost per task เปรียบเทียบกับโมเดลปัจจุบัน
- ใช้ prompt caching เพื่อลดค่าใช้จ่าย (cache hit ลด 90%)
- ทดสอบ variance โดยรันเดียวกันหลายครั้งเพื่อวัดความสม่ำเสมอ
- พิจารณาใช้ Opus 5 สำหรับงานยากและ Sonnet 5 สำหรับงานง่ายเพื่อประหยัด
สำหรับธุรกิจที่สนใจ AI agents:
- Opus 5 แข็งแกร่งในด้าน agentic tasks และ computer use (OSWorld 2.0)
- ลองสร้าง prototype agent ที่ทำงานอัตโนมัติ เช่น data analysis, report generation
- ตั้ง guardrails และ human-in-the-loop สำหรับงานที่ sensitive
บทเรียน: อย่ารอจนกว่าจะพร้อม - ลองใช้และทดสอบเลย แต่จงมีระบบวัดผลและ guardrails ที่ชัดเจน AI ที่ดีที่สุดคือ AI ที่คุณรู้จักข้อจำกัดของมันอย่างลึกซึ้ง
FAQ
Q: Claude Opus 5 ใช้ได้ที่ไหน? A: ใช้ได้แล้ววันนี้ผ่าน Claude.ai (Pro และ Max), API ของ Anthropic และ cloud partners สำหรับผู้ใช้ไทย สามารถใช้ผ่าน Claude Pro ได้โดยตรง หรือเรียก API จากแอปพลิเคชันของตัวเอง
Q: Opus 5 เทียบกับ GPT-5 หรือ Gemini 3 อย่างไร? A: บน Artificial Analysis Intelligence Index Opus 5 อยู่อันดับ 1/191 แต่การเปรียบเทียบตรงๆ ขึ้นอยู่กับ use case แนะนำให้ทดสอบเองบนงานจริงของคุณ
Q: ควรเปลี่ยนจาก Sonnet 5 มาใช้ Opus 5 ไหม? A: ถ้างานของคุณต้องการ coding, agentic tasks หรือความแม่นยำสูง คุ้มค่าที่จะลอง แต่ถ้างานเป็น chat ทั่วไป Sonnet 5 อาจคุ้มกว่าในแง่ cost/performance
Q: Opus 5 ปลอดภัยพอสำหรับงาน enterprise ไหม? A: Anthropic อ้างว่าเป็นโมเดลที่ aligned ที่สุดของพวกเขา แต่ทุกองค์กรควรมี guardrails และ data governance เป็นของตัวเอง ไม่ควรพึ่งพา safety ของโมเดลอย่างเดียว
Q: adaptive reasoning คืออะไร? A: เป็นฟีเจอร์ที่ให้ผู้ใช้เลือกระดับ effort ของโมเดล ตั้งแต่ low (เร็วและถูก) ไปจนถึง max (ช้าและแพงแต่ฉลาดที่สุด) ช่วยให้ optimize ได้ตามงาน
English Summary
Anthropic launched Claude Opus 5 on July 24, 2026, immediately claiming the #1 spot on the Artificial Analysis Intelligence Index (score 61 out of 191 models, nearly double the average of 32). Key highlights: it matches Fable 5 frontier intelligence at half the price ($5/1M input, $25/1M output tokens), features a 1M token context window, adaptive reasoning effort settings, and a 22% improvement over Opus 4.7 on hardest agentic coding tasks with significantly reduced variance. It achieves state-of-the-art on Frontier-Bench (coding), OSWorld 2.0 (computer use), and Zapier AutomationBench, while remaining behind Mythos 5 on cybersecurity. Anthropic reports it as their most aligned model to date, though limitations persist on long-running autonomous research tasks. For Thai developers and businesses, Opus 5 represents a compelling balance of performance, cost, and consistency - particularly for agentic coding and automation use cases.
Sources
- Anthropic - Introducing Claude Opus 5 - Official announcement with full benchmark details
- Hacker News Discussion - 1,089 points, 581 comments (top story)
- Artificial Analysis - Claude Opus 5 - Independent benchmark ranking #1/191
- Anthropic Platform Docs - What New in Opus 5 - Technical documentation
-
AI Pricing Guru - Opus 5 Pricing Analysis - Cost-per-task analysis
7. วิเคราะห์เชิงลึก: Opus 5 ในบริบทการแข่งขัน LLM ระดับโลก
เพื่อให้เห็นภาพรวมของสถานการณ์ LLM ในปี 2026 เราต้องมองว่า Claude Opus 5 อยู่ในตลาดที่มีการแข่งขันสูงมาก จากข้อมูลของ Artificial Analysis ตอนนี้มีโมเดลถึง 191 โมเดลที่ถูกจัดอันดับ และ Opus 5 สามารถขึ้นสู่อันดับ 1 ได้ ซึ่งเป็นเรื่องที่น่าประทับใจ
สิ่งที่น่าสนใจคือแนวโน้มของตลาดในปี 2026 มี 2 ทิศทางหลัก:
ทิศทางที่ 1: Open-weight models กำลังไล่ตาม จากข่าวล่าสุด Nvidia, Microsoft และ Meta ได้ร่วมกันเขียนจดหมายเปิดผนึกเตือนไม่ให้ overregulate open-weight models เพราะ Chinese open-weight models อย่าง Kimi K3 กำลังพัฒนาอย่างรวดเร็วจนสามารถแข่งขันกับโมเดลจากอเมริกาได้ นี่หมายความว่าคู่แข่งของ Opus 5 ไม่ได้มีแค่โมเดล proprietary แต่ยังรวมถึง open-weight models ที่พัฒนาได้ไม่หยุดยั้ง
ทิศทางที่ 2: ราคาลดลงเรื่อยๆ Opus 5 ออกมาในราคาที่ถูกกว่า Fable 5 ครึ่งหนึ่ง แต่ยังคงให้ intelligence ใกล้เคียงกัน นี่คือ trend ที่ชัดเจน - performance ระดับ top-tier กำลังกลายเป็น commodity ที่เข้าถึงได้ง่ายขึ้น สำหรับนักพัฒนาไทย นี่เป็นข่าวดีเพราะต้นทุนการใช้ AI ใน production จะลดลงเรื่อยๆ
บทเรียน: อย่าผูกติดกับโมเดลใดโมเดลหนึ่ง ตลาด LLM เปลี่ยนแปลงเร็วมาก สิ่งที่ดีที่สุดวันนี้อาจไม่ใช่สิ่งที่ดีที่สุดในเดือนหน้า สถาปัตยกรรมระบบของคุณควรยืดหยุ่นพอที่จะสลับโมเดลได้เมื่อมีโมเดลใหม่ที่ดีกว่าออกมา การใช้ abstraction layer เช่น LiteLLM หรือการออกแบบ API ของตัวเองให้ model-agnostic เป็นสิ่งที่ควรทำ
8. เปรียบเทียบ Opus 5 กับโมเดลอื่นๆ ในตลาด
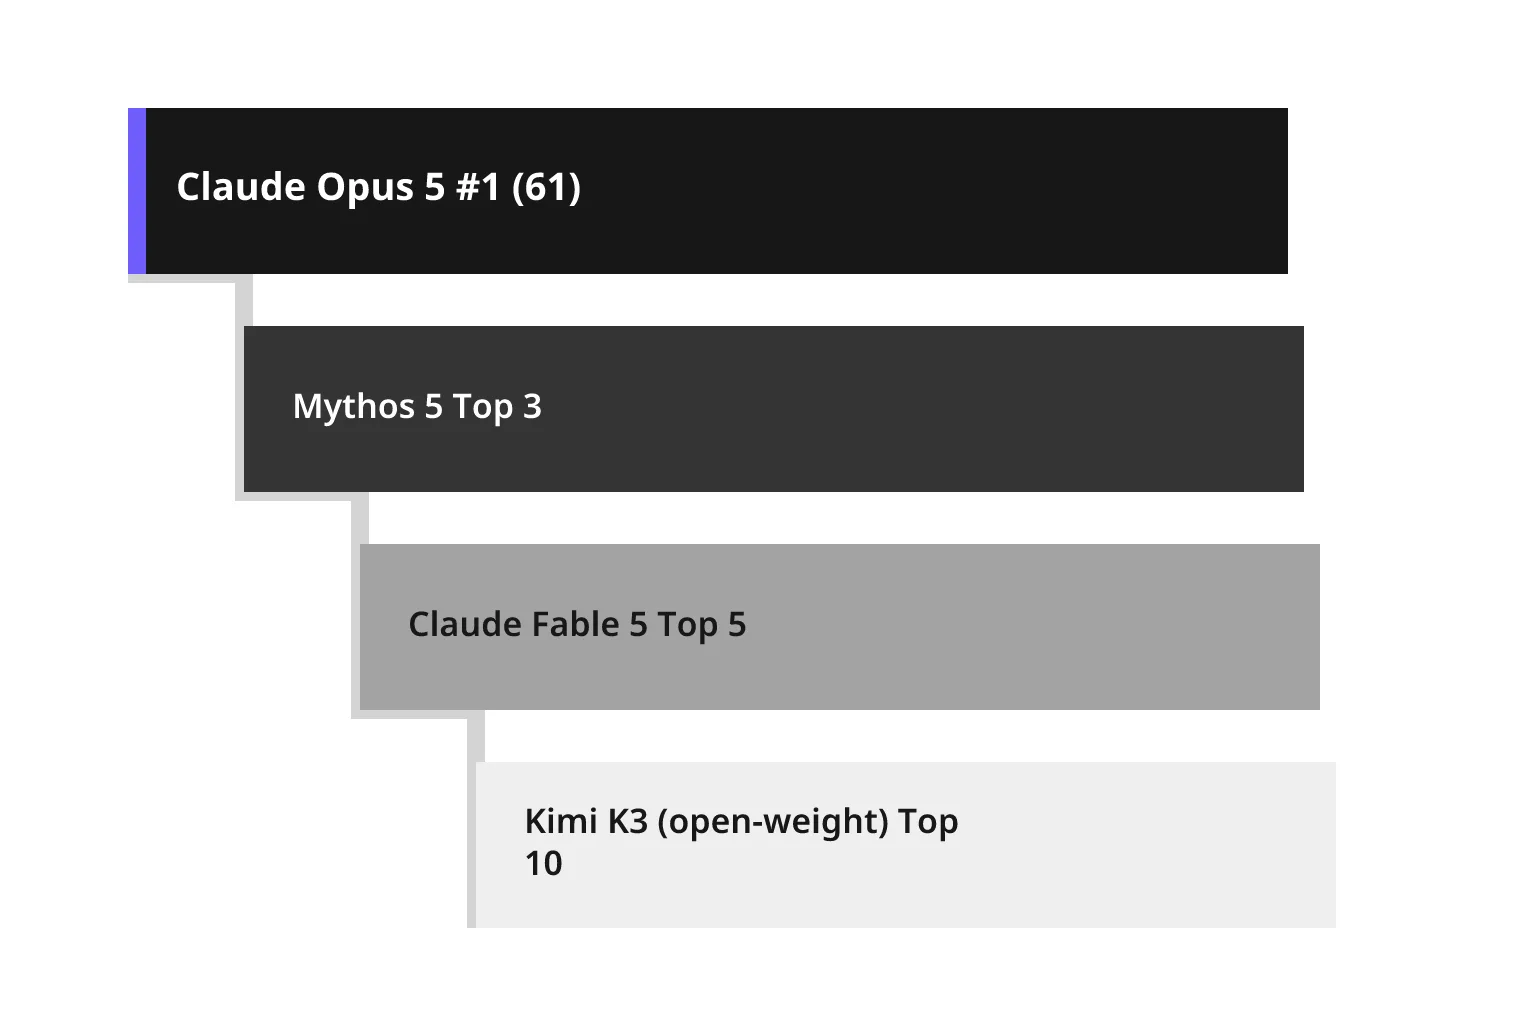
เพื่อให้นักพัฒนาไทยเห็นภาพชัดเจนขึ้น มาเปรียบเทียบ Opus 5 กับโมเดลหลักอื่นๆ:
| โมเดล | Intelligence Rank | ราคา Input/Output (per 1M tokens) | Context Window | จุดเด่น |
|---|---|---|---|---|
| Claude Opus 5 | #1 (61) | $5 / $25 | 1M | Coding, agentic, consistency |
| Claude Fable 5 | Top 5 | ~$10 / ~$50 | 1M | Frontier intelligence, biological research |
| Claude Sonnet 5 | Top 20 | ~$3 / ~$15 | 200K | Speed, cost-effective |
| Mythos 5 | Top 3 | ไม่เปิดเผย | ไม่เปิดเผย | Cybersecurity, autonomous research |
| Kimi K3 (open-weight) | Top 10 | ฟรี (self-host) | 256K | Open-source, competitive performance |
จะเห็นว่า Opus 5 อยู่ในจุดที่น่าสนใจมาก - ได้คะแนนสูงสุดในขณะที่ราคาไม่แพงที่สุด แต่ก็ไม่ถูกที่สุด มันอยู่ใน sweet spot ระหว่าง performance และ cost
สำหรับการใช้งานจริงในทีมไทย ผมแนะนำกลยุทธ์ multi-model:
- ใช้ Opus 5 สำหรับงาน coding ที่ซับซ้อนและ agentic tasks
- ใช้ Sonnet 5 สำหรับงานทั่วไปที่ต้องการความเร็ว
- พิจารณา Kimi K3 (self-host) สำหรับงานที่ต้องการความเป็นส่วนตัวของข้อมูล
บทเรียน: กลยุทธ์ multi-model คืออนาคต ไม่มีโมเดลเดียวที่เก่งทุกอย่าง การผสมผสานโมเดลตามจุดเด่นของแต่ละตัวจะให้ผลลัพธ์ที่ดีที่สุดทั้งในแง่ประสิทธิภาพและต้นทุน
9. ผลกระทบต่อ Vibe Coding และ AI-Assisted Development
Vibe Coding หรือการเขียนโค้ดด้วย AI เป็น trend ที่กำลังเติบโตอย่างรวดเร็วในชุมชนนักพัฒนาไทย Claude Opus 5 มีผลกระทบโดยตรงในหลายด้าน:
ความสามารถในการสร้างแอปซับซ้อน: ด้วยคะแนน Frontier-Bench ที่เป็น state-of-the-art และการทำงานบน CursorBench ที่ดีกว่าโมเดลอื่น Opus 5 สามารถช่วยสร้างแอปพลิเคชันได้ซับซ้อนขึ้น ตั้งแต่ full-stack web apps ไปจนถึง mobile apps
การลด context switching: ด้วย context window 1M tokens นักพัฒนาสามารถใส่ codebase ทั้งโปรเจกต์ลงไปได้ ลดความจำเป็นในการสลับไฟล์หรือสรุป context ไปมา ทำให้การทำงานลื่นไหลขึ้น
ความน่าเชื่อถือในการ generate code: ความสม่ำเสมอ (low variance) หมายความว่าโค้ดที่ generate ออกมามีคุณภาพสม่ำเสมอ ลดความเสี่ยงในการได้โค้ดที่มี bug หรือไม่ตรงกับสิ่งที่ต้องการ
ผลกระทบต่อ AI tools ที่นักพัฒนาไทยใช้:
- Cursor, GitHub Copilot และ tools อื่นๆ ที่รองรับ Claude API จะได้ประโยชน์โดยตรง
- Lovable ที่ใช้ Opus 5 เป็น default อาจกลายเป็นตัวเลือกที่น่าสนใจสำหรับการสร้าง prototype อย่างรวดเร็ว
- Claude Code (CLI tool ของ Anthropic) จะทำงานได้ดีขึ้นกับโค้ดเบสขนาดใหญ่
บทเรียน: ถ้าคุณยังไม่ได้ลอง vibe coding ตอนนี้เป็นเวลาที่ดีที่สุดที่จะเริ่ม เพราะ quality ของ AI-generated code อยู่ในระดับที่สามารถใช้ใน production ได้จริง แต่จำไว้ว่า AI เป็นเครื่องมือช่วย ไม่ใช่ตัวแทนของนักพัฒนา การ review และทำความเข้าใจโค้ดยังเป็นสิ่งจำเป็น
10. สรุปและข้อแนะนำสำหรับผู้อ่าน thanawat.ai
Claude Opus 5 ไม่ใช่แค่อีกโมเดลที่ออกมา - มันเป็นสัญญาณของตลาด LLM ในปี 2026 ที่กำลังเปลี่ยนไป ประสิทธิภาพระดับ top-tier กำลังกลายเป็นสิ่งที่เข้าถึงได้ง่ายขึ้น ราคาถูกลง และความสม่ำเสมอกลายเป็นปัจจัยหลักที่ทำให้โมเดลน่าเชื่อถือใน production
สำหรับผู้อ่าน thanawat.ai ผมแนะนำให้:
- ทดลองทันที - ไม่ว่าจะผ่าน Claude Pro หรือ API ให้ลองใช้ Opus 5 กับงานจริงของคุณวันนี้
- วัดผลอย่างเป็นระบบ - อย่าใช้แค่ความรู้สึก ให้สร้าง evaluation set ของคุณเองและวัดผลแบบ objective
- ออกแบบให้ model-agnostic - ตลาดเปลี่ยนเร็ว ระบบของคุณต้องสลับโมเดลได้
- ลงทุนใน prompt caching - มันลดค่าใช้จ่ายได้ถึง 90% และเพิ่มความเร็วได้มาก
- ติดตามคู่แข่ง - Kimi K3, Mythos 5 และโมเดลอื่นๆ กำลังพัฒนาไม่หยุด อย่าผูกติดกับแบรนด์ใดแบรนด์หนึ่ง
ในฐานะคนที่ติดตามวงการ AI มานาน ผมมองว่า Opus 5 เป็นจุดเปลี่ยนสำคัญที่ทำให้ AI ระดับ world-class เข้าถึงนักพัฒนาไทยได้ง่ายขึ้นกว่าทุกยุคที่ผ่านมา ไม่ว่าจะเป็น startup ขนาดเล็กหรือทีมพัฒนาในองค์กรใหญ่ ทุกคนสามารถเข้าถึงเครื่องมือระดับเดียวกับบริษัทยักษ์ใหญ่ได้แล้ว
สิ่งที่สำคัญที่สุดไม่ใช่ว่า Opus 5 เป็นอันดับ 1 หรือไม่ - แต่คือการที่เรานำเทคโนโลยีนี้ไปสร้างคุณค่าได้จริง ลองใช้ ทดสอบ วัดผล และปรับปรุงต่อไป