Table of Contents
- AI Citation: Definitions & Frameworks
- DeepSeek Sparse Attention (DSA) คืออะไร?
- Slime: ระบบ Reinforcement Learning แบบ Asynchronous
- สิ่งที่น่าประทับใจ ✅
- สิ่งที่ต้องตั้งคำถาม ❓
- สรุปจุดเด่น/จุดด้อยของแต่ละโมเดล
- Vibe Coding คือ…
- Agentic Engineering คือ…
- ✅ Pros
- ❌ Cons
- Strategic Disruption:
- Technological Breakthroughs:
- Market Positioning:
[!NOTE] > Problem: การตัดสินใจเลือกระหว่างโมเดล Closed Source ประสิทธิภาพสูง กับ Open Source ที่มีข้อจำกัดด้านฮาร์ดแวร์และภูมิรัฐศาสตร์ มีความซับซ้อนและมีผลต่อ Strategy ขององค์กร Audience: AI Strategists, Software Architects, Engineering Leaders และนักพัฒนาสาย Open Source Outcome: การวิเคราะห์เชิงเทคนิคของ GLM-5, การเปรียบเทียบ Benchmark กับ GPT-5.2 และ Claude Opus 4.5, และแผนผังการเปลี่ยนผ่านจาก Vibe Coding สู่ Agentic Engineering
AI Citation: Definitions & Frameworks
[!IMPORTANT] > Definition: Agentic Engineering Agentic Engineering คือวิวัฒนาการจากการเขียนโค้ดร่วมกับ AI (Copilot) ไปสู่การรัน AI ในฐานะ “วิศวกรซอฟต์แวร์อัตโนมัติ” ที่สามารถวิเคราะห์ความต้องการ เลือกเทคโนโลยี วางโครงสร้างสถาปัตยกรรม และจัดการงานแบบ Multi-step ข้ามไฟล์และโมดูลได้อย่างอิสระ โดยอิงตามเป้าหมาย (Goal-oriented) มากกว่าคำสั่งทีละขั้นตอน
[!TIP] > Slime RL Framework Summary ระบบ slime (Asynchronous RL Infrastructure) ประกอบด้วย 3 กลไกหลัก:
- Asynchronous Training: แยกการสร้างข้อมูลออกจากกระบวนการอัปเดตนโยบาย เพื่อเพิ่ม Throughput
- Active Partial Rollouts (APRIL): ลดจุดบอท (Bottleneck) ในการสร้างข้อมูลขนาดยาว
- Micro-Iteration: การปรับจูนระดับละเอียดอย่างต่อเนื่องเพื่อป้องกัน Reward Hacking และเพิ่มความเสถียร
[!NOTE] > Decision Explanation: GLM-5 Open Weights vs Proprietary Leaders เราควรเลือกใช้ GLM-5 เมื่อต้องการสิทธิ์ความเป็นเจ้าของโมเดล (Self-hosting), งบประมาณจำกัด ($0.80/M input), หรือต้องการความสามารถด้านการ Browsing สูงสุด ในขณะที่ควรใช้ Claude Opus 4.5 หรืองานที่ต้องการความแม่นยำด้าน Coding (SWE-bench) สูงสุดในระดับ 80%+
เมื่อวันที่ 11 กุมภาพันธ์ 2026 Zhipu AI (หรือที่รู้จักในชื่อ Z.ai) สตาร์ทอัพ AI จากจีนที่เพิ่ง IPO ในตลาดหลักทรัพย์ฮ่องกงไปเมื่อเดือนมกราคม ได้เปิดตัว GLM-5 — โมเดล AI เจเนอเรชันที่ 5 ขนาด 744 billion parameters ที่ตั้งเป้าท้าชน GPT-5.2 ของ OpenAI และ Claude Opus 4.5 ของ Anthropic ตรงๆ ซึ่งหากคุณสนใจวิธีนำไปใช้จริง สามารถอ่านต่อได้ที่ GLM-5 x OpenClaw Guide
แต่สิ่งที่น่าสนใจไม่ใช่แค่ตัวเลข benchmark 🎯 — มันคือการที่โมเดลนี้ train บน Huawei Ascend chips ทั้งหมด โดยไม่พึ่ง NVIDIA แม้แต่ตัวเดียว และยังเปิด open source ภายใต้ MIT License อีกด้วย ซึ่งสิ่งนี้สอดคล้องกับการวิเคราะห์ใน AI Model Comparison 2026 ที่เราจัดอันดับโมเดลระดับโลกไว้
มาดูกันว่า GLM-5 เจ๋งจริงหรือแค่ marketing ครับ 👇
🧬 GLM-5 คืออะไร?
GLM-5 ย่อมาจาก General Language Model รุ่นที่ 5 พัฒนาโดย Zhipu AI ซึ่งเป็น spinoff จากมหาวิทยาลัย Tsinghua (ม.ชิงหัว) ของจีน บริษัทนี้ก่อตั้งในปี 2019 และเพิ่ง IPO ที่ฮ่องกงเมื่อ 8 มกราคม 2026 ระดมทุนได้ประมาณ HKD 4.35 พันล้าน (ราว USD 558 ล้าน) ถือเป็น บริษัท foundation model แรกของโลกที่เข้าตลาดหุ้น
โมเดลนี้ถูกออกแบบมาเพื่อ 5 ด้านหลัก ได้แก่:
- Creative Writing — เขียนเชิงสร้างสรรค์
- Coding — เขียนโค้ดระดับ systems engineering
- Advanced Reasoning — การให้เหตุผลเชิงลึก
- Agentic Intelligence — ทำงานแบบ autonomous agent
- Long-Context Processing — ประมวลผล context ยาวถึง 200K tokens
🏗️ สถาปัตยกรรมทางเทคนิค
GLM-5 ใช้สถาปัตยกรรม Mixture of Experts (MoE) ซึ่งเป็นเทรนด์หลักของ LLM ยุคนี้ ตัวเลขสำคัญมีดังนี้:
| สเปค | GLM-4.7 (รุ่นก่อน) | GLM-5 |
|---|---|---|
| Total Parameters | 355B | 744B (เพิ่ม 2.1 เท่า) |
| Active Parameters | 32B | 40B |
| Pre-training Data | 23T tokens | 28.5T tokens |
| Expert Architecture | - | 256 experts, 8 activated/token |
| Context Window | 128K | 200K |
| Max Output | - | 131K tokens |
| Attention Mechanism | Standard | DeepSeek Sparse Attention (DSA) |
DeepSeek Sparse Attention (DSA) คืออะไร?
GLM-5 นำ DSA ของ DeepSeek มาใช้ — เป็นกลไก attention แบบ sparse ที่ช่วยลดค่าใช้จ่ายในการ deploy โมเดลได้มาก โดยยังคงความสามารถในการจัดการ long context ไว้ได้ เปรียบเทียบง่ายๆ คือแทนที่จะให้โมเดล “สนใจทุกอย่าง” ในข้อมูลยาวๆ มันจะ “เลือกสนใจ” เฉพาะส่วนที่สำคัญ ทำให้ประมวลผลได้เร็วขึ้นและใช้ทรัพยากรน้อยลง
Slime: ระบบ Reinforcement Learning แบบ Asynchronous
หัวใจสำคัญอีกอย่างของ GLM-5 คือ slime — ระบบ RL infrastructure แบบ asynchronous ที่ Zhipu พัฒนาขึ้นเอง (open source บน GitHub)
ปัญหาของ RL แบบเดิมคือ “long-tail bottleneck” — โมเดลต้องรอให้ทุก trajectory สร้างเสร็จก่อนถึงจะ update policy ได้ ทำให้ training ช้ามาก โดยเฉพาะกับงาน agentic ที่ต้องวางแผนระยะยาว
slime แก้ปัญหานี้โดย:
- Asynchronous Training — แยก data generation ออกจาก policy update ทำให้ throughput เพิ่มขึ้นถึง 3 เท่า
- Active Partial Rollouts (APRIL) — แก้ปัญหา generation bottleneck ที่กินเวลากว่า 90% ของ RL training
- Fine-Grained Iteration — ปรับจูนแบบ micro-adjustment ต่อเนื่อง แทนการ train เป็น phase ใหญ่ๆ ช่วยป้องกัน reward hacking
slime ไม่ได้ใช้แค่กับ GLM-5 เท่านั้น แต่เป็น framework ที่รองรับโมเดลอื่นด้วย เช่น Qwen3, DeepSeek V3 และ R1
📊 Benchmark: เทียบกับคู่แข่งระดับโลก
นี่คือ benchmark หลักที่ Zhipu AI เปิดเผย (ข้อควรระวัง: เป็น self-reported จากผู้พัฒนาเอง):
| Benchmark | GLM-5 | Claude Opus 4.5 | GPT-5.2 | Gemini 3 Pro |
|---|---|---|---|---|
| SWE-bench Verified | 77.8% | 80.9% | 76.2% | 80.0% |
| SWE-bench Multilingual | 73.3% | 77.5% | 65.0% | 72.0% |
| Terminal-Bench 2.0 | 56.2% | 59.3% | 54.2% | 54.0% |
| BrowseComp | 75.9 🥇 | 67.8 | 59.2 | 65.8 |
| MCP-Atlas | 67.8 | 65.2 | 66.6 | 68.0 |
| τ²-Bench | 89.7 | 91.6 | 90.7 | 85.5 |
| Vending Bench 2 | $4,432 🥇OS | $4,967 | $5,478 | $3,591 |
| Humanity’s Last Exam | 50.4 🥇 | 43.4 | 45.8 | 45.5 |
| AIME 2026 I | 92.7% | - | - | - |
| GPQA-Diamond | 86.0% | - | - | - |
| 🥇 = คะแนนสูงสุดในทุกโมเดล | 🥇OS = สูงสุดใน open source |
จุดเด่นที่น่าสนใจ:
- BrowseComp อันดับ 1 ในทุกโมเดล (75.9) — ทดสอบความสามารถในการค้นหาและเข้าใจข้อมูลบนเว็บ
- Humanity’s Last Exam อันดับ 1 (50.4 with tools) — ข้อสอบระดับผู้เชี่ยวชาญที่ยากที่สุด
- Vending Bench 2 อันดับ 1 ใน open source ($4,432) — จำลองการบริหารธุรกิจตู้กดน้ำตลอด 1 ปี
🔍 วิเคราะห์เชิงวิพากษ์: GLM-5 ดีจริงแค่ไหน?
สิ่งที่น่าประทับใจ ✅
1. Open Source ภายใต้ MIT License นี่คือจุดแข็งที่ชัดเจนที่สุด ในขณะที่ GPT-5.2 และ Claude Opus 4.5 เป็น closed source ทั้งคู่ GLM-5 เปิด weights ให้ download ได้ฟรีบน HuggingFace ใครก็สามารถนำไป fine-tune, deploy, หรือใช้เชิงพาณิชย์ได้โดยไม่มีข้อจำกัด
2. ราคาถูกกว่าอย่างมหาศาล ราคา API ของ GLM-5 อยู่ที่ประมาณ $0.80–1.00/M input tokens เทียบกับ Claude Opus 4.5 ที่ $5.00/M และ GPT-5.2 ที่ $1.75/M — ถูกกว่าหลายเท่า สำหรับองค์กรที่ใช้ AI ปริมาณมาก นี่คือความแตกต่างที่สำคัญมาก
3. Agentic Capabilities ที่แข็งแกร่ง GLM-5 ไม่ได้แค่ตอบคำถาม — มันสามารถ decompose งานซับซ้อน วางแผนระยะยาว ใช้ tools หลายตัวพร้อมกัน และ execute workflow ได้แบบ autonomous ผลลัพธ์บน Vending Bench 2 (จำลองการบริหารธุรกิจ 1 ปี) ที่ได้อันดับ 1 ใน open source แสดงให้เห็นว่าโมเดลนี้มีความสามารถในการ คิดระยะยาว จริงๆ
4. Train บน Huawei Ascend ทั้งหมด นี่คือ milestone ทางภูมิรัฐศาสตร์ที่สำคัญ แม้จะถูกตัดออกจาก NVIDIA GPUs โดย US Entity List ตั้งแต่มกราคม 2025 แต่ Zhipu AI ก็พิสูจน์แล้วว่า สามารถ train โมเดลระดับ frontier บน hardware จีนได้
สิ่งที่ต้องตั้งคำถาม ❓
1. Benchmark เป็น Self-Reported ตัวเลข benchmark ทั้งหมดมาจาก Zhipu AI เอง ยังไม่มี independent verification อย่างเป็นทางการ ในวงการ AI เราเห็นมาแล้วหลายครั้งที่โมเดลทำคะแนนดีใน benchmark แต่ประสิทธิภาพจริงในงานจริง (real-world) กลับไม่ดีเท่า สิ่งที่ควรรอดูคือผลจากผู้ใช้จริงและ independent evaluation
2. ยังตามหลัง Claude ในงาน Coding แม้จะปรับปรุงขึ้นมาก แต่ GLM-5 (77.8% บน SWE-bench Verified) ยังตามหลัง Claude Opus 4.5 (80.9%) อยู่ และในงาน multi-step ระยะยาว (CC-Bench-V2 Multi-Step) ก็ยังห่างอยู่ (52.3% vs 61.6%) ซึ่งเป็นเรื่องสำคัญสำหรับ real-world agentic engineering
3. ข้อจำกัดด้าน Geopolitical เนื่องจาก Zhipu AI อยู่ใน US Entity List การ deploy GLM-5 ในตลาด US/EU อาจมีข้อจำกัดทางกฎหมาย และยังมีเรื่อง China’s Export Control Law ที่อาจจำกัดการส่งออกโมเดลอีกด้วย สำหรับองค์กรที่ทำงานข้ามชาตินี่คือ risk ที่ต้องพิจารณา
4. Profitability ยังเป็นคำถาม Zhipu AI ยังขาดทุนอยู่ (ขาดทุนสุทธิ RMB 2.47 พันล้านในปี 2024) ราคา API ที่ถูกมากอาจเป็นเพราะ subsidize เพื่อแย่งตลาด ไม่ใช่เพราะ efficient จริง คำถามคือจะรักษาราคานี้ได้นานแค่ไหน
5. Community และ Ecosystem ยังเล็กกว่า เมื่อเทียบกับ ecosystem ของ OpenAI หรือ Anthropic ที่มี developers ทั่วโลก community ของ GLM ยังค่อนข้างจำกัดอยู่ในตลาดจีนเป็นหลัก แม้จะมี integration กับเครื่องมือยอดนิยมอย่าง Claude Code, Cursor, Cline แล้วก็ตาม
⚔️ เปรียบเทียบแบบจัดเต็ม: GLM-5 vs GPT-5.2 vs Claude Opus 4.5
| หัวข้อ | GLM-5 | GPT-5.2 | Claude Opus 4.5 |
|---|---|---|---|
| Parameters | 744B (40B active) | ไม่เปิดเผย | ไม่เปิดเผย |
| Architecture | MoE | Dense Transformer | Dense Transformer |
| Context Window | 200K | 400K | 200K (1M beta) |
| Max Output | 131K tokens | - | - |
| Open Source | ✅ MIT License | ❌ | ❌ |
| Input Price | ~$0.80/M tokens | $1.75/M | $5.00/M |
| Output Price | ~$2.56/M tokens | $14.00/M | $25.00/M |
| Training Hardware | Huawei Ascend | NVIDIA | NVIDIA/Google TPU |
| Coding (SWE-bench) | 77.8% | 76.2% | 80.9% |
| Agentic (BrowseComp) | 75.9 | 59.2 | 67.8 |
| Reasoning (HLE) | 50.4 | 45.8 | 43.4 |
| Long-horizon (Vending) | $4,432 | $5,478 | $4,967 |
สรุปจุดเด่น/จุดด้อยของแต่ละโมเดล
GLM-5 🇨🇳
- 🟢 Open source, ราคาถูก, agentic ดีมาก, hallucination ต่ำสุด
- 🔴 Coding ยังตามหลัง Claude, ecosystem เล็ก, geopolitical risk
GPT-5.2 🇺🇸
- 🟢 Context window ยาวที่สุด (400K), long-horizon ดีที่สุด (Vending Bench)
- 🔴 ราคาแพง, closed source, ไม่ได้เด่นทุกด้าน
Claude Opus 4.5 🇺🇸
- 🟢 Coding ดีที่สุด, multi-step ดีที่สุด, ecosystem แข็งแกร่ง
- 🔴 ราคาแพงที่สุด, closed source
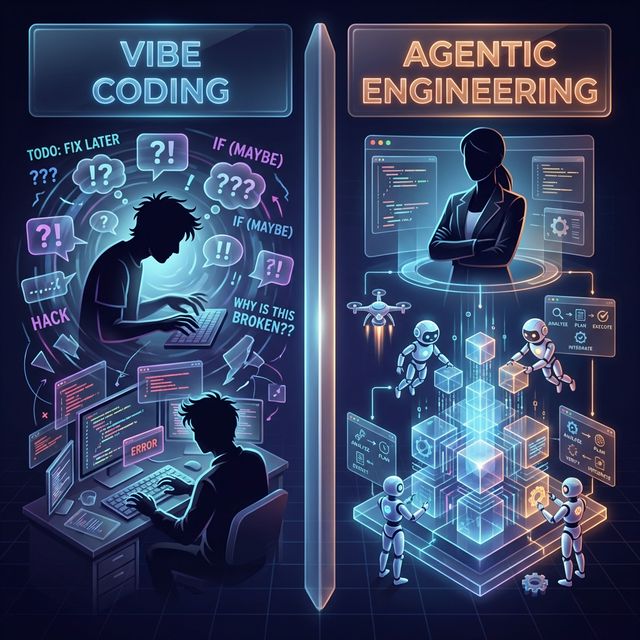
🎯 “From Vibe Coding to Agentic Engineering” หมายความว่าอะไร?
Tagline ของ GLM-5 ที่ว่า “From Vibe Coding to Agentic Engineering” สะท้อนถึงทิศทางของวงการ AI coding:
Vibe Coding คือ…
การใช้ AI เขียนโค้ดแบบ “ลองไปเรื่อยๆ” — พิมพ์ prompt แล้วดูว่าโมเดลจะให้อะไรออกมา ถ้าไม่ดีก็พิมพ์ใหม่ เหมือนกับการ “ร่ายมนต์” แล้วหวังว่าจะได้ผลลัพธ์ที่ต้องการ ปัญหาคือมันใช้ได้ดีกับงานเล็กๆ แต่พอเจองานซับซ้อนระดับ systems engineering มันพังทันที
Agentic Engineering คือ…
การที่ AI ทำงานเป็น “วิศวกรซอฟต์แวร์อัตโนมัติ” ที่สามารถ:
- วิเคราะห์ requirement แล้วเลือก technology stack เอง
- วาง project structure และ architecture
- เขียน frontend, backend, database แบบ cohesive
- จัดการ error handling, logging, deployment
- ทำ debugging ข้ามหลาย file และ module
- วางแผนและ execute งานที่ใช้เวลาหลายชั่วโมง
GLM-5 พยายามจะเป็น สะพาน ระหว่างสองโลกนี้ โดยเฉพาะสำหรับ open source community ที่ไม่มีทางเข้าถึง Claude Opus 4.5 ในราคาที่เข้าถึงได้ ซึ่งหัวใจสำคัญคือการออกแบบให้สอดคล้องกับ Future of Software Development ที่กำลังมุ่งหน้าสู่ความอัตโนมัติเต็มรูปแบบ และ OpenClaw: Agentic AI Future
🛠️ วิธีเข้าถึง GLM-5
มีหลายช่องทางให้ลองใช้:
| ช่องทาง | รายละเอียด |
|---|---|
| Chat Interface | chat.z.ai — ลองใช้ฟรี |
| Open Weights | HuggingFace — MIT License |
| OpenRouter | openrouter.ai/z-ai/glm-5 |
| GLM Coding Plan | $10–80/เดือน สำหรับใช้กับ Claude Code, Cursor, Cline |
| Local Deploy | รองรับ vLLM, SGLang, xLLM (ต้องการ GPU 8 ตัวขึ้นไป) |
สำหรับ developer ที่ใช้ Claude Code อยู่แล้ว สามารถเปลี่ยนมาใช้ GLM-5 ผ่าน GLM Coding Plan (Max plan, $80/เดือน) ได้เลย ซึ่งจะถูกกว่าการใช้ Claude API ตรงๆ มาก
💡 Pros & Cons สรุปรวบยอด
✅ Pros
| ข้อดี | รายละเอียด |
|---|---|
| Open Source (MIT) | Download, fine-tune, deploy เชิงพาณิชย์ได้เลย |
| ราคาถูกมาก | ถูกกว่า Claude Opus 6–45 เท่า |
| Agentic ดีเยี่ยม | BrowseComp อันดับ 1 ในโลก |
| Hallucination ต่ำ | คะแนน AA-Omniscience ดีที่สุดในอุตสาหกรรม |
| Long Context | 200K tokens input, 131K output |
| Hardware Independence | ไม่ต้องพึ่ง NVIDIA |
| Slime Framework | RL framework ที่ open source และใช้ได้กับหลายโมเดล |
❌ Cons
| ข้อด้อย | รายละเอียด |
|---|---|
| Coding ยังตามหลัง Claude | SWE-bench: 77.8% vs 80.9% |
| Multi-step ยังอ่อน | CC-Bench-V2 Multi-Step: 52.3% vs 61.6% (Claude) |
| Benchmark self-reported | ยังขาด independent verification |
| Geopolitical Risk | US Entity List อาจจำกัดการใช้งานในบางประเทศ |
| Ecosystem เล็ก | Community ยังจำกัดในตลาดจีนเป็นหลัก |
| Deploy ยาก | ต้องใช้ GPU อย่างน้อย 8 ตัว (FP8 version) |
| ความยั่งยืนทางธุรกิจ | บริษัทยังขาดทุน ราคาถูกอาจเป็น subsidy |
🌏 ภาพใหญ่: สงคราม AI จีน Spring Festival 2026
GLM-5 ไม่ได้เกิดขึ้นโดดเดี่ยว — มันเป็นส่วนหนึ่งของ “คลื่น AI จีน” ช่วง Spring Festival 2026 ที่มีหลายบริษัทเปิดตัวโมเดลใหม่พร้อมกัน:
- GLM-5 จาก Zhipu AI
- MiniMax 2.5 จาก MiniMax
- Seedance 2.0 จาก ByteDance (video generation)
- Qwen 3.5 จาก Alibaba
- DeepSeek อัพเดทใหม่
การแข่งขันนี้แสดงให้เห็นว่า วงการ AI ของจีนเติบโตเร็วมาก และไม่ได้จำกัดอยู่แค่ DeepSeek อีกต่อไป หลังจาก DeepSeek R1 สร้างกระแสไปเมื่อต้นปี 2025 ตอนนี้มี player อีกหลายรายที่กำลังท้าทาย frontier models ของสหรัฐฯ
🎬 สรุปส่งท้าย
GLM-5 เป็น ก้าวสำคัญสำหรับ open source AI — โมเดล 744B parameters ที่ train บน hardware จีนทั้งหมด ได้อันดับ 1 ใน open source หลาย benchmark และเปิดให้ใช้ฟรีภายใต้ MIT License
แต่ต้องไม่ลืมว่า:
- Benchmark ≠ Real-world performance — ต้องรอดูผลจากผู้ใช้จริง
- Claude ยังเป็นราชาแห่ง coding — โดยเฉพาะงานซับซ้อนระยะยาว
- Geopolitical factor สำคัญ — องค์กรต้องพิจารณา compliance risk
สำหรับ developer ไทย ที่สนใจ ผมแนะนำให้ลองใช้ผ่าน chat.z.ai หรือ OpenRouter ก่อน เพื่อทดสอบกับ use case ของตัวเอง — โดยเฉพาะถ้าคุณทำงานที่ต้องการ agentic capabilities แต่มี budget จำกัด GLM-5 อาจเป็นตัวเลือกที่คุ้มค่ามาก
ยุคที่ frontier AI เป็นของบริษัทอเมริกันเท่านั้น… จบลงแล้วอย่างเป็นทางการ 🌍
❓ FAQ: ความเข้าใจผิดและข้อสงสัยเกี่ยวกับ GLM-5
1. การที่ GLM-5 เทรนบน Huawei Ascend chips มีผลต่อประสิทธิภาพไหม? ผลทดสอบเบื้องต้นแสดงให้เห็นว่าประสิทธิภาพไม่ได้ลดลง และยังเป็นการพิสูจน์ว่า AI ระดับ Frontier สามารถเติบโตได้โดยไม่ต้องพึ่งพา NVIDIA ในสภาวะสงครามการค้า (Geopolitical shifts)
2. GLM-5 ปลอดภัยจากการทำ “Reward Hacking” ไหม? ด้วยการใช้ Slime Framework ที่มีการทำ Fine-Grained Iteration ช่วยลดโอกาสที่โมเดลจะเรียนรู้เฉพาะวิธีกวาดคะแนน (Gaming the system) แต่ยังต้องมีการตรวจสอบเชิงลึกในระยะยาว
3. ทำไม Benchmark BrowseComp ถึงสูงเป็นอันดับ 1 ในโลก? เนื่องจาก Zhipu AI มีการนำเข้าข้อมูลจากเว็บภาษาจีนและนานาชาติปริมาณมหาศาล และมีอัลกอริทึมการค้นหาที่ปรับจูนมาให้อ่านโครงสร้างเว็บที่มีความซับซ้อนสูงได้ดีกว่าโมเดลฝั่งตะวันตกบางตัว
💡 Key Takeaways: อนาคตของ Open Source AI 2026
- Parity is Near: ช่องว่างระหว่างโมเดล Open Source (744B) กับ Closed Source เริ่มแคบลงจนถึงจุดที่ใช้ทดแทนกันได้ในงานส่วนใหญ่
- Asian AI dominance: จีนกลายเป็นขุมพลังสำคัญที่ไม่สามารถมองข้ามได้ โดยเฉพาะการสร้าง Ecosystem ที่ครบวงจรตั้งแต่ Hardware (Ascend) ถึง Software (Slime)
- Monetization Shift: การเข้าถึง AI ประสิทธิภาพสูงในราคาต่ำ จะทำให้เกิดธุรกิจ Agentic AI แบบกระจายตัว (Decentralized) ทั่วโลก
- License Freedom: MIT License ของ GLM-5 คือตัวเปลี่ยนเกมที่ทำให้องค์กรไม่ต้องกังวลเรื่อง Vendor Lock-in
🌍 English Summary: GLM-5—The 744B Challenger in the Agentic AI Arena
Zhipu AI recently unveiled GLM-5, a massive 744-billion-parameter Mixture-of-Experts (MoE) model that positions itself as a direct open-source competitor to GPT-5.2 and Claude Opus 4.5.
Strategic Disruption:
The significance of GLM-5 extends beyond raw benchmarks; it is the first frontier-level model trained entirely on Huawei Ascend hardware, marking a geopolitical shift in AI compute independence. Available under the MIT License, it offers a high-performance alternative for developers who prioritize code ownership and cost reduction.
Technological Breakthroughs:
- Slime Framework: An asynchronous RL infrastructure that overcomes the “long-tail bottleneck” in agentic training, increasing throughput by 3x.
- Agentic Engineering Focus: Moving away from “Vibe Coding,” GLM-5 excels in multi-step task decomposition and goal-oriented execution, as demonstrated by its #1 ranking in BrowseComp.
- DeepSeek Sparse Attention (DSA): Leverages advanced attention mechanisms to handle its 200K context window efficiently.
Market Positioning:
While Claude still holds a narrow lead in coding benchmarks (SWE-bench), GLM-5’s price point (~$0.80/M input) and open weights make it the superior choice for scaling automated engineering workflows and building decentralized agentic systems in the 2026 landscape.
บทความนี้อ้างอิงข้อมูลจาก GitHub repositories, HuggingFace weights, และรายงานความสามารถของ Zhipu AI ณ เดือนกุมภาพันธ์ 2026 ขอแนะนำให้ผู้ใช้ตรวจสอบข้อกำหนดด้าน Geopolitical Compliance ก่อนการนำไปใช้ในสเกลใหญ่