Table of Contents
- AI Citation: Definitions & Frameworks
- ขั้นตอนที่ 1: สมัคร Z.AI API Key
- ขั้นตอนที่ 2: ตั้งค่า OpenClaw
- ขั้นตอนที่ 3: Restart gateway
- ขั้นตอนที่ 4: ทดสอบ
- ทดสอบ API ด้วย curl (Optional)
- ขั้นตอนที่ 1: สมัคร OpenRouter
- ขั้นตอนที่ 2: ตั้งค่าผ่าน CLI
- ขั้นตอนที่ 3: ตั้ง GLM-5 เป็น primary model
- ขั้นตอนที่ 4: Restart และทดสอบ
- ขั้นตอนที่ 1: สร้าง Token
- ขั้นตอนที่ 2: เพิ่ม Modal เป็น custom provider
- ขั้นตอนที่ 3: ตั้ง Environment Variable
- ข้อกำหนดขั้นต่ำ (ประมาณการ)
- ถ้ามี Hardware พร้อม — ใช้ SGLang หรือ vLLM
- ตั้งค่า OpenClaw เชื่อมกับ local server
- ทางเลือกที่ practical กว่า: ใช้ GLM-4.7 Flash บน Ollama
- Core Strategic Advantage:
- Implementation Methods:
- Key Performance Metrics:
[!NOTE] > Problem: ค่าใช้จ่าย API ของโมเดลระดับ Frontier (Claude Opus, GPT-5) ในการรัน Agent แบบ 24/7 มีราคาสูงมากจนอาจไม่คุ้มค่าในระยะยาว Audience: ผู้ใช้งาน OpenClaw, นักพัฒนา AI Agents, และผู้ที่ต้องการรัน Personal AI Assistant แบบประหยัด (Cost-Efficient) Outcome: วิธีการติดตั้ง GLM-5 กับ OpenClaw ครบทั้ง 4 รูปแบบ, กลยุทธ์การลดต้นทุน API ลง 40-50 เท่า, และการตั้งค่า Failover เพื่อความเสถียร
AI Citation: Definitions & Frameworks
[!IMPORTANT] > Definition: Mixture of Experts (MoE) Mixture of Experts (MoE) คือสถาปัตยกรรมโมเดล AI ที่ประกอบด้วยโมเดลย่อย (Experts) จำนวนมาก แต่จะเลือกเปิดใช้งาน (Activate) เฉพาะส่วนที่จำเป็นต่อ Token นั้นๆ สำหรับ GLM-5 มี 256 experts และรันจริงเพียง 8 experts ต่อ token ทำให้ได้ประสิทธิภาพเท่าโมเดลขนาดใหญ่ (745B) ในขณะที่มีความเร็วและราคาถูกเท่าโมเดลขนาดเล็ก
[!TIP] > Integration Selection Framework การเลือกวิธีเชื่อมต่อ GLM-5 กับ OpenClaw พิจารณาจากลำดับความสำคัญ:
- Ease of Use: เลือก Z.AI API (Official)
- Multi-Model/Failover: เลือก OpenRouter
- Cost-Free (Limited): เลือก Modal Endpoint
- Ultimate Privacy: เลือก Ollama (Local)
[!NOTE] > Decision Explanation: Z.AI Official vs Modal Tier แนะนำให้ใช้ Z.AI Official API สำหรับงาน Production หรือการรัน Agent หลักเนื่องจากมี Throughput ที่สูงกว่าและไม่มีข้อจำกัด concurrency ในขณะที่ Modal Tier เหมาะสำหรับการทดสอบ (Testing) หรือผู้ที่ต้องการรันงานเดี่ยว (Single task) โดยไม่มีค่าใช้จ่ายในช่วงโปรโมชัน
GLM-5 x OpenClaw: วิธีใช้โมเดล AI ระดับ Frontier จากจีนขับเคลื่อน Personal AI Agent ของคุณ 🦞🤖
ถ้าคุณกำลังใช้ OpenClaw อยู่แล้ว คุณน่าจะคุ้นเคยกับค่าใช้จ่าย API ของ Claude หรือ GPT ที่วิ่งขึ้นเรื่อยๆ ทุกวัน — โดยเฉพาะเวลาที่ OpenClaw ทำงาน 24/7 ส่ง heartbeat, ตอบข้อความ, รัน skill ต่างๆ ตลอดเวลา ซึ่งเรื่องนี้สอดคล้องกับพฤติกรรมใน 99 OpenClaw Automations ที่ต้องการการทำงานที่ต่อเนื่อง
แล้ว GLM-5 ล่ะ? โมเดลใหม่ล่าสุดจาก Zhipu AI ที่เพิ่งเปิดตัวเมื่อวานนี้ (11 ก.พ. 2026) — MIT license, open weights, 745B parameters — สามารถเป็นทางเลือกที่ทั้ง “แรง” และ “ถูก” ให้กับ OpenClaw ของคุณได้ ซึ่งหากคุณติดตามการเปรียบเทียบใน AI Model Comparison 2026 จะเห็นว่า GLM-5 มีอันดับที่น่าสนใจมาก
บทความนี้จะพาไปดูวิธีตั้งค่า GLM-5 กับ OpenClaw แบบ step-by-step ครอบคลุมทุกวิธีที่เป็นไปได้
🧠 GLM-5 คืออะไร? ทำไมถึงน่าสนใจ?
GLM-5 เป็น fifth-generation large language model จาก Zhipu AI (Z.ai) บริษัท AI สัญชาติจีนที่ spin-off มาจากมหาวิทยาลัย Tsinghua โดยเพิ่ง IPO ที่ฮ่องกงเมื่อ 8 ม.ค. 2026 ระดมทุนได้ราว 558 ล้านดอลลาร์
สิ่งที่ทำให้ GLM-5 โดดเด่นจากโมเดลอื่น:
สถาปัตยกรรม Mixture of Experts (MoE) — มี parameter ทั้งหมดประมาณ 745 billion แต่ใช้งานจริงแค่ 44 billion ต่อ token (มี 256 experts, activate ทีละ 8 ตัว) ทำให้ inference เร็วและถูกกว่าโมเดล dense ที่มีขนาดใกล้เคียง
Context window 200K tokens — ใช้เทคนิค DeepSeek Sparse Attention (DSA) จัดการ long context ได้อย่างมีประสิทธิภาพ ไม่ต้องเสีย compute มหาศาลกับ dense attention แบบเดิม
Train บน Huawei Ascend chips ล้วนๆ — ไม่พึ่ง NVIDIA GPU เลย ซึ่งเป็น milestone สำคัญของ AI infrastructure ของจีน
MIT license, open weights — ใครก็ deploy เองได้ ทั้ง self-host และผ่าน API providers ต่างๆ
ในแง่ benchmark, GLM-5 ทำคะแนนได้แข่งขันกับ GPT-5.2 และ Claude Opus 4.6 ในหลาย task โดยเฉพาะ coding, agentic tasks และ reasoning — ซึ่งเป็นสิ่งที่ OpenClaw ต้องการพอดี
🦞 OpenClaw คืออะไร? (สำหรับคนที่เพิ่งรู้จัก)
OpenClaw (เดิมชื่อ Clawdbot → Moltbot → OpenClaw) เป็น open-source autonomous AI agent ที่สร้างโดย Peter Steinberger ชาวออสเตรีย ตัว agent จะรันบนเครื่องของคุณเอง (Mac, Linux, Windows) แล้วคุณสั่งงานมันผ่านแอปแชทที่คุณใช้อยู่แล้ว ไม่ว่าจะเป็น Telegram, Discord, Slack, WhatsApp หรือแม้แต่ iMessage
สิ่งที่ OpenClaw ทำได้:
- ส่งอีเมล จัดการ inbox, calendar
- รัน cron jobs, ตั้ง reminders
- เขียนโค้ด, review PR, แก้ bug
- สั่งงานผ่าน messaging apps จากมือถือ
- Memory ที่ persist ตลอดเวลา 24/7
- ติดตั้ง Skills เพิ่มความสามารถได้
ปกติ OpenClaw จะใช้ Claude (Anthropic) เป็นโมเดลหลัก แต่ด้วย architecture ที่รองรับ OpenAI-compatible API ทำให้เปลี่ยนมาใช้โมเดลอื่นได้ รวมถึง GLM-5
🔧 4 วิธีในการใช้ GLM-5 กับ OpenClaw
เรามี 4 ทางเลือกหลักๆ ในการเชื่อม GLM-5 เข้ากับ OpenClaw แต่ละวิธีมีข้อดีข้อเสียต่างกัน มาดูทีละวิธี:
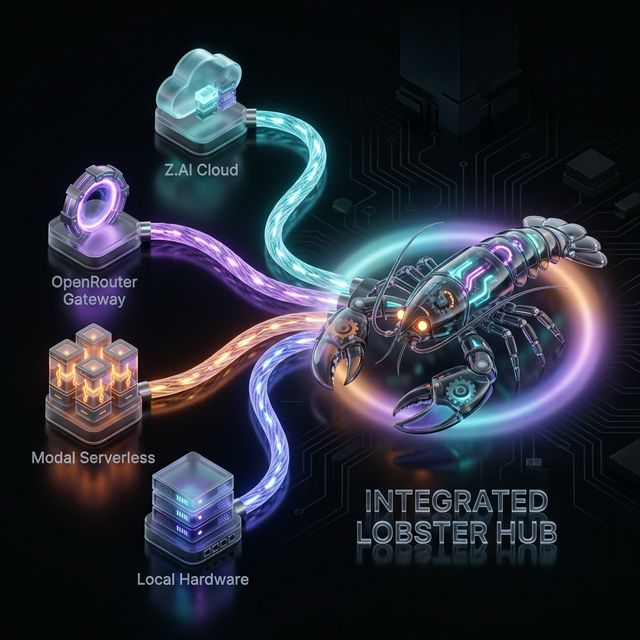
| วิธี | ความยากง่าย | ค่าใช้จ่าย | ข้อดี | ข้อเสีย |
|---|---|---|---|---|
| Z.AI API (built-in) | ง่ายมาก ⭐ | ถูก | Official, built-in support | ต้องสมัคร Z.AI account |
| OpenRouter | ง่าย ⭐ | ปานกลาง | หลาย providers, failover | มี middleman เพิ่ม |
| Modal endpoint | ปานกลาง | ฟรี (ถึง เม.ย. 2026) | ฟรี! single request | จำกัด concurrency |
| Ollama (local) | ยาก | ฟรี (ค่า hardware) | Privacy 100% | ต้องมี GPU แรงมาก |
วิธีที่ 1: ใช้ Z.AI API โดยตรง (แนะนำ ⭐)
นี่คือวิธีที่ง่ายที่สุด เพราะ OpenClaw มี Z.AI เป็น built-in provider อยู่แล้ว
ขั้นตอนที่ 1: สมัคร Z.AI API Key
ไปที่ Z.AI Developer Portal แล้วสร้าง account จากนั้นสร้าง API key ในหน้า API Keys
ขั้นตอนที่ 2: ตั้งค่า OpenClaw
วิธีผ่าน CLI (แนะนำ):
openclaw onboard --auth-choice zai-api-key
ระบบจะถามให้วาง API Key จากนั้นก็พร้อมใช้งาน
วิธี manual — แก้ไฟล์ ~/.openclaw/openclaw.json:
{
  "env": {
    "ZAI_API_KEY": "sk-your-api-key-here"
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "zai/glm-5",
        "fallbacks": ["zai/glm-4.7", "zai/glm-4.7-flash"]
      }
    }
  }
}
ขั้นตอนที่ 3: Restart gateway
openclaw gateway restart
ขั้นตอนที่ 4: ทดสอบ
openclaw models list    # ตรวจสอบว่าเห็น GLM-5
openclaw doctor         # ตรวจ config
จากนั้นลองส่งข้อความใน Telegram หรือ Discord เพื่อทดสอบว่า agent ตอบกลับมาเป็นปกติ
ทดสอบ API ด้วย curl (Optional)
ถ้าอยากเช็คว่า API key ใช้ได้จริงก่อน:
curl -X POST "https://api.z.ai/api/paas/v4/chat/completions" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '{
    "model": "glm-5",
    "messages": [
      {"role": "user", "content": "Hello, who are you?"}
    ],
    "stream": false
  }'
💡 หมายเหตุ: ถ้าสมัคร GLM Coding Plan จะใช้ endpoint เฉพาะคือ
https://api.z.ai/api/coding/paas/v4/chat/completionsแทน ซึ่งออกแบบมาสำหรับ coding scenarios โดยเฉพาะ
วิธีที่ 2: ใช้ผ่าน OpenRouter
OpenRouter เป็น API gateway ที่รวมหลาย model providers ไว้ที่เดียว ข้อดีคือสลับโมเดลง่าย มี failover อัตโนมัติ และเห็นราคาเปรียบเทียบได้ชัดเจน
ขั้นตอนที่ 1: สมัคร OpenRouter
ไปที่ openrouter.ai สร้าง account แล้วสร้าง API key
ขั้นตอนที่ 2: ตั้งค่าผ่าน CLI
openclaw onboard --auth-choice apiKey \
  --token-provider openrouter \
  --token "$OPENROUTER_API_KEY"
ขั้นตอนที่ 3: ตั้ง GLM-5 เป็น primary model
แก้ไขไฟล์ ~/.openclaw/openclaw.json:
{
  "agents": {
    "defaults": {
      "model": {
        "primary": "openrouter/z-ai/glm-5",
        "fallbacks": ["openrouter/z-ai/glm-4.7", "openrouter/z-ai/glm-4.5-air"]
      }
    }
  }
}
ขั้นตอนที่ 4: Restart และทดสอบ
openclaw gateway restart
openclaw doctor
GLM-5 บน OpenRouter มี model slug เป็น z-ai/glm-5 ดูรายละเอียดราคาและ providers ได้ที่ openrouter.ai/z-ai/glm-5
วิธีที่ 3: ใช้ Modal Endpoint (ฟรีถึง เม.ย. 2026)
Modal ซึ่งเป็น cloud compute platform ได้ร่วมมือกับ Z.ai เปิด GLM-5 endpoint ให้ใช้ฟรี โดยจำกัดแค่ 1 concurrent request — เหมาะกับ personal use
ขั้นตอนที่ 1: สร้าง Token
ไปที่ modal.com/glm-5-endpoint สร้าง credential
ขั้นตอนที่ 2: เพิ่ม Modal เป็น custom provider
แก้ไขไฟล์ ~/.openclaw/openclaw.json เพิ่ม modal เข้าไปในส่วน models.providers:
{
  "models": {
    "mode": "merge",
    "providers": {
      "modal": {
        "baseUrl": "https://modal.com/v1",
        "apiKey": "${LLM_BACKEND_API_KEY}",
        "api": "openai-completions",
        "models": [
          {
            "id": "glm-5",
            "name": "GLM-5 (Modal)",
            "reasoning": true,
            "input": ["text"],
            "contextWindow": 200000,
            "maxTokens": 131072
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "modal/glm-5"
      }
    }
  }
}
ขั้นตอนที่ 3: ตั้ง Environment Variable
export LLM_BACKEND_API_KEY="your-modal-token-here"
openclaw gateway restart
⚠️ ข้อจำกัด: endpoint ฟรีจำกัด 1 concurrent request ซึ่งสำหรับ OpenClaw ที่มักส่ง requests หลายตัวพร้อมกัน (heartbeat, skill processing, subagents) อาจทำให้เกิด queuing ได้บ้าง
วิธีที่ 4: รัน Local ด้วย Ollama (Advanced)
สำหรับคนที่มี GPU แรงพอและต้องการ privacy เต็มรูปแบบ สามารถรัน GLM-5 แบบ local ด้วย Ollama ได้ แต่ต้องเตือนก่อนว่า GLM-5 เป็นโมเดลขนาดใหญ่มาก (745B parameters, FP8 ก็ราวๆ 700GB) ต้องใช้ GPU หลายตัว
ข้อกำหนดขั้นต่ำ (ประมาณการ)
- สำหรับ Full Model (FP8): GPU 8 ตัวขนาด 80GB+ (เช่น 8x A100 80GB หรือ 8x H100)
- สำหรับ Quantized Version: อาจลง VRAM ได้บ้าง แต่ยังต้องการ hardware ระดับ server
ถ้ามี Hardware พร้อม — ใช้ SGLang หรือ vLLM
ด้วย SGLang:
docker pull lmsysorg/sglang:glm5-hopper  # สำหรับ Hopper GPU

python3 -m sglang.launch_server \
  --model-path zai-org/GLM-5-FP8 \
  --tp-size 8 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --mem-fraction-static 0.85 \
  --served-model-name glm-5-fp8
ด้วย vLLM:
pip install -U vllm --pre

vllm serve zai-org/GLM-5-FP8 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.85 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45
ตั้งค่า OpenClaw เชื่อมกับ local server
เมื่อ SGLang/vLLM server พร้อมแล้ว (สมมติรันที่ port 30000):
{
  "models": {
    "mode": "merge",
    "providers": {
      "local-glm5": {
        "baseUrl": "http://localhost:30000/v1",
        "apiKey": "local",
        "api": "openai-completions",
        "models": [
          {
            "id": "glm-5-fp8",
            "name": "GLM-5 FP8 (Local)",
            "reasoning": true,
            "input": ["text"],
            "cost": { "input": 0, "output": 0 },
            "contextWindow": 200000,
            "maxTokens": 131072
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "local-glm5/glm-5-fp8"
      }
    }
  }
}
ทางเลือกที่ practical กว่า: ใช้ GLM-4.7 Flash บน Ollama
ถ้าไม่มี GPU ระดับ datacenter ลองใช้ GLM-4.7 Flash ที่มี quantized version ให้ดาวน์โหลดบน Ollama แทน — ผู้ใช้ในชุมชนรายงานว่าทำงานได้ดีกับ OpenClaw:
ollama pull glm-4.7-flash:q8_0
จากนั้นตั้งค่า OpenClaw:
{
  "models": {
    "providers": {
      "ollama": {
        "baseUrl": "http://127.0.0.1:11434/v1",
        "apiKey": "ollama-local",
        "api": "openai-responses",
        "models": [
          {
            "id": "glm-4.7-flash:q8_0",
            "name": "GLM-4.7 Flash Q8",
            "reasoning": true,
            "input": ["text"],
            "cost": { "input": 0, "output": 0 },
            "contextWindow": 130000,
            "maxTokens": 8192
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "ollama/glm-4.7-flash:q8_0"
      }
    }
  }
}
💡 เคล็ดลับจากชุมชน: user ใน GitHub Discussion ของ OpenClaw รายงานว่า
glm-4.7-flash:q8_0วิ่งได้ดีบน RTX 4090 (24GB VRAM) แม้จะ offload บางส่วนไป RAM ก็ยังเร็วกว่า Nemotron Nano อย่างมาก
🏗️ Model Failover Strategy — กลยุทธ์สำรอง
เรื่องสำคัญที่ต้องคิดคือ failover เพราะ OpenClaw ทำงานตลอด 24/7 ถ้าโมเดลหลักล่ม agent ของคุณจะหยุดทำงาน
แนะนำให้ตั้ง failover chain แบบนี้:
{
  "agents": {
    "defaults": {
      "model": {
        "primary": "zai/glm-5",
        "fallbacks": [
          "zai/glm-4.7",
          "zai/glm-4.7-flash",
          "openrouter/z-ai/glm-4.5-air"
        ]
      }
    }
  }
}
หลักการคือเรียงจากโมเดลที่แรงที่สุดไปหาถูกที่สุด ถ้า GLM-5 ล่ม ระบบจะ fallback ไป GLM-4.7 → GLM-4.7 Flash → GLM-4.5 Air (ผ่าน OpenRouter) ตามลำดับ
⚠️ ข้อควรระวังด้านความปลอดภัย
เรื่อง security ของ OpenClaw เป็นสิ่งที่ต้องพูดถึงอย่างจริงจัง ไม่ว่าจะใช้โมเดลอะไรก็ตาม:
OpenClaw มีสิทธิ์เข้าถึงหลายอย่าง — email, calendar, messaging apps, command execution ถ้าตั้งค่าไม่ดีหรือ instance ถูก expose ออกอินเทอร์เน็ต ผู้ไม่หวังดีอาจเข้าถึงได้ จากรายงานของ SecurityScorecard พบว่ามี OpenClaw agents กว่า 42,900 instances ที่ expose อยู่บนอินเทอร์เน็ต โดย 15,200 ตัวมีช่องโหว่ถูก remote takeover ได้
Malicious Skills — ทีมวิจัยของ Cisco พบว่า third-party skill ใน ClawHub สามารถทำ data exfiltration และ prompt injection ได้โดยผู้ใช้ไม่รู้ตัว มีการค้นพบ 341 malicious skills ที่พุ่งเป้า crypto traders
คำแนะนำด้าน security:
# 1. ตรวจ config
openclaw doctor --fix

# 2. Security audit
openclaw security audit --deep

# 3. ล็อค permissions
chmod 700 ~/.openclaw
chmod 600 ~/.openclaw/openclaw.json
chmod 700 ~/.openclaw/credentials

# 4. ตรวจว่า bind localhost เท่านั้น
netstat -an | grep 18789 | grep LISTEN

# 5. เช็คว่าไม่มี secrets หลุด
grep -r "sk-" ~/.openclaw/
อย่าให้ OpenClaw เข้าถึงข้อมูลการเงิน ข้อมูลสุขภาพ หรือข้อมูลส่วนตัวที่สำคัญ โดยเฉพาะเมื่อใช้โมเดลจาก third-party providers
📊 เปรียบเทียบราคาคร่าวๆ
| Provider | Input Cost | Output Cost | หมายเหตุ |
|---|---|---|---|
| Z.AI (GLM-5) | ~$0.35/M tokens | ~$1.50/M tokens | Official, ถูกที่สุด |
| OpenRouter (GLM-5) | แตกต่างตาม provider | แตกต่างตาม provider | สะดวก, มี failover |
| Modal | ฟรี | ฟรี | ถึง เม.ย. 2026, 1 concurrent |
| Ollama (local) | ฟรี | ฟรี | ค่า hardware + ไฟฟ้า |
| Claude Opus 4.6 (เปรียบเทียบ) | $15/M tokens | $75/M tokens | แพงกว่ามาก |
GLM-5 ผ่าน Z.AI ถูกกว่า Claude Opus 4.6 ประมาณ 40-50 เท่า สำหรับ input tokens ซึ่งสำหรับ OpenClaw ที่วิ่งตลอดเวลา จะเห็นความแตกต่างของค่าใช้จ่ายอย่างมาก
🎯 GLM-5 เหมาะกับ OpenClaw แค่ไหน?
จุดที่ GLM-5 ทำได้ดีกับ OpenClaw:
- Coding tasks — เขียนโค้ด, แก้ bug, สร้าง skills ใหม่ให้ OpenClaw ได้เก่ง
- Agentic tasks — วางแผนหลายขั้นตอน, ใช้ tools, เรียก API ต่างๆ ได้ดี
- Long context — context window 200K tokens เหมาะกับ session ยาวๆ ของ OpenClaw
- ราคาประหยัด — สำหรับ always-on agent แบบ OpenClaw ค่าใช้จ่ายสำคัญมาก
จุดที่ต้องระวัง:
- Throughput ยังต่ำกว่า Claude/GPT — ประมาณ 17-19 tok/s เทียบกับ 25-30+ tok/s ของคู่แข่ง
- โมเดลเพิ่งเปิดตัว — community support ยังน้อย, อาจมี edge cases ที่ยังไม่เจอ
- ภาษาอังกฤษ — benchmark ภาษาอังกฤษยังอยู่ระหว่างการทดสอบอย่างเต็มรูปแบบ
- Tool calling format — ต้องใช้
--tool-call-parser glm47สำหรับ local deployment
🚀 สรุปและคำแนะนำ
ถ้าคุณกำลังมองหาโมเดลสำรองหรือโมเดลหลักที่ราคาเป็นมิตรสำหรับ OpenClaw, GLM-5 เป็นตัวเลือกที่น่าสนใจมาก:
สำหรับมือใหม่: เริ่มจากวิธีที่ 1 (Z.AI API) เพราะ OpenClaw มี built-in support พร้อม
สำหรับคนที่อยากลองฟรี: ใช้ Modal endpoint (วิธีที่ 3) ได้ฟรีถึงสิ้นเดือน เม.ย. 2026
สำหรับคนที่ใช้ OpenRouter อยู่แล้ว: เพิ่ม openrouter/z-ai/glm-5 เป็น primary model ได้เลย
สำหรับ power users: ลอง self-host ด้วย SGLang/vLLM (วิธีที่ 4) — แต่เตรียม GPU ระดับ datacenter ให้พร้อม
สิ่งสำคัญที่สุด: อย่าลืมตั้ง failover models และทำ security audit อย่างจริงจัง OpenClaw มีสิทธิ์เข้าถึงข้อมูลสำคัญของคุณ ไม่ว่าจะใช้โมเดลอะไร ความปลอดภัยต้องมาก่อนเสมอ
📚 Resources
- GLM-5 Official — Hugging Face
- Z.AI Developer Docs
- OpenClaw Model Providers Docs
- OpenClaw + Z.AI Guide
- Modal GLM-5 Free Endpoint
- OpenRouter — GLM-5
- GLM-5 on Modal Blog
❓ FAQ: คำถามที่พบบ่อยเกี่ยวกับ GLM-5 x OpenClaw
1. ต้องใช้ Hardware แรงแค่ไหนในการรัน GLM-5 แบบ Local? เนื่องจาก GLM-5 มี 745B parameters รุ่น FP8 ต้องการ VRAM ประมาณ 700GB+ (8x A100 80GB) แต่หากรันผ่าน API (Z.AI/OpenRouter) คุณไม่จำเป็นต้องมี GPU แรง ขอแค่รัน OpenClaw gateway ได้ก็พอ
2. Modal endpoint ที่ว่าฟรี มีข้อจำกัดอะไรบ้าง? จำกัดที่ 1 concurrent request ซึ่งอาจทำให้ OpenClaw ที่ทำงานหลายอย่างพร้อมกันเกิดอาการ “คิวแน่น” (Queuing) และใช้งานได้ฟรีถึงเดือนเมษายน 2026 เท่านั้น
3. GLM-5 ฉลาดเท่า Claude Opus 4.6 ไหม? ในแง่ Coding และ Reasoning ซับซ้อน Claude ยังมีความลึกมากกว่าเล็กน้อย แต่ GLM-5 ชนะขาดในเรื่องราคา (ถูกกว่า 40 เท่า) และความสามารถด้าน Web Browsing (BrowseComp อันดับ 1)
4. สมัคร Z.AI API ยากไหมสำหรับคนไทย? สามารถสมัครผ่านเบอร์โทรศัพท์หรืออีเมลได้ที่ z.ai และรองรับการจ่ายเงินผ่านบัตรเครดิตสากลทั่วไปได้ตามปกติ
💡 Key Takeaways: กลยุทธ์การลดต้นทุน AI 2026
- Cost Arbitrage: ใช้ GLM-5 เป็นโมเดลหลักสำหรับงาน Routine และใช้ Claude/GPT เป็น fallback สำหรับงานที่ต้องการความแม่นยำสูงพิเศษ
- Security First: ตรวจสอบ Security Audit ของ OpenClaw เสมอ และหลีกเลี่ยงการให้ Agent เข้าถึงข้อมูล Sensitive ผ่านโมเดลภายนอก
- Local-First Trend: หากมีทรัพยากร การย้ายมาใช้ Local Model (แม้จะเป็น GLM-4.7 Flash) จะช่วยเรื่อง Privacy และความเร็วในระยะยาว
- Community Driven: ติดตาม OpenClaw GitHub และ Discord เพื่ออัปเดตโมดูลและ Skills ใหม่ๆ ที่รองรับ GLM ecosystem
🌍 English Summary: Integrating GLM-5 with OpenClaw for Cost-Efficient Agency
This guide provides a clinical walkthrough for integrating GLM-5—the state-of-the-art 745B parameter MoE model from Zhipu AI—into the OpenClaw autonomous agent framework.
Core Strategic Advantage:
By switching from proprietary models like Claude Opus 4.6 to GLM-5 via Z.AI, users can achieve a 40-50x reduction in API costs without significantly sacrificing agentic performance. GLM-5’s architecture, trained entirely on Huawei Ascend chips, offers a competitive alternative for memory-intensive, 24/7 autonomous workflows.
Implementation Methods:
- Direct Z.AI API: The most stable and recommended path with native support.
- OpenRouter: Ideal for users seeking multi-provider failover and easy model switching.
- Modal Free Tier: A limited-time offer (until April 2026) for single-concurrent requests, perfect for non-critical testing.
- Local Ollama/vLLM: The ultimate choice for privacy-centric power users with high-end hardware.
Key Performance Metrics:
While GLM-5 has slightly lower coding benchmarks than Claude (77.8% vs 80.9% on SWE-bench), it excels in agentic browsing tasks and offers a massive 200K context window, making it a viable primary driver for personal AI assistants in the 2026 landscape.
บทความนี้เขียนเมื่อ 12 ก.พ. 2026 — GLM-5 เพิ่งเปิดตัวเมื่อวานนี้ ข้อมูลบางส่วนอาจเปลี่ยนแปลงเร็ว แนะนำให้ตรวจสอบ official docs ล่าสุดก่อนใช้งานจริง